Mình lên Google (không phải ChatGPT nhen), gõ “re-engineering”, và được gợi ý một từ khóa cụ thể hơn: “business process engineering”. Mình tiếp tục đọc về nó trong Wikipedia, để nắm được thông tin sơ lược là trào lưu này đã bắt đầu từ 1990s và tiếp tục tìm được một bài viết tổng hợp do bác Thomas Davenport viết năm 2007, với tiêu đề “Trào lưu đã lãng quên con người: https://web.archive.org/web/20071107044721/http://www.rotman.utoronto.ca/~evans/teach363/fastco/reengin.htm
Sau khi đọc bài viết này, mình cảm thấy sao mà nó trúng quá đi. Những cơn hào hứng, nỗi buồn đau những ngày xưa ấy khi được gọi tên ra tuy không giải quyết được vấn đề ngay lập tức, nhưng ít nhất cho mình biết được có ai đó trên thế gian này cũng quan tâm đến chúng, như mình vậy. Và mình nhận ra, những lúc cảm thấy quá xá bất ổn với những từ ngữ đao to búa lớn bủa vây trên mạng, một cách cắt cơn stress của mình là google “buzzword X” + history + criticism. Mình muốn hiểu đến tận ngọn nguồn tại sao đứa con tinh thần ấy ra đời, nó đã lớn lên như thế nào, được “trọng dụng” và “lợi dụng” ra sao.
Và mình cũng vui biết bao nhiêu khi stalk tác giả, và biết được hóa ra Thomas H Davenport chính là bác Tom Davenport mà mình đã follow từ hồi nảo nào vì bác có rất nhiều bài viết hay về data, analytics, knowledge management. Bài viết từ năm 2007 của bác khiến mình nhận ra thêm một yếu tố khác khiến mình thích đọc bác hơn: trên tất cả những thứ về business, hiệu suất, etc… thì yếu tố “con người” vẫn là niềm quan tâm lo lớn của bác. Ngay cả trong cuốn sách gần nhất về Agentic AI, bác cũng nhấn mạnh vai trò của “human in the loop”.
Và không ngạc nhiên, xuất thân của bác chính là Sociology!
Bác khiến mình tự tin hơn vào quyết định dẫn thân vào Sociology sắp tới.
Và đó là câu chuyện trí tò mò đã kéo mình đi thật xa, và đưa mình trở lại, cho mình thêm niềm tin rằng con đường mình đang đi có vẻ cũng đã có người từng đi, và những mảnh ghép rời rạc mà mình đang có, đang từ từ ghép lại với nhau.
10 năm đi làm thì có đến 5,5 năm mình mang chức danh Learning & Development Executive. Và trong chừng ấy thời gian, mình liên tục vật lộn với việc mô tả công việc của mình một cách chính xác cho những ai không làm trong lĩnh vực nhân sự. Với số đông, mình mô tả L&D trong công ty giống như phòng giáo vụ ở trường đại học; với những ai không quen với mô hình trường lớp, mình nói đơn giản rằng mình giống như trợ giảng. Nhưng dù là giáo vụ hay trợ giảng, hai từ này vẫn không bao quát hết những gì mình làm, vì mình làm mọi thứ để việc học diễn ra trong một tổ chức, chỉ là không đứng lớp mà thôi.
Rồi đến một ngày đầu năm 2022, mình đọc một cuốn sách của World Bank có tên The Art of Knowledge Exchange, và bắt gặp cụm từ learning broker (mình tạm dịch là “cò học”, lấy cảm hứng từ “cò đất, cò nhà”). Một từ thôi, nhưng nó gom hết những việc mình làm trong suốt những năm lăn lộn với Learning & Development (L&D). Đó là một aha moment! Mình khoái quá, viết hẳn một bài trên Facebook, được nhiều anh chị em chung nghề thương mến bình luận “cảm ơn con cò”, bởi cái từ đó nó đúng quá đi! Và cái tư duy “cò học” đó đã đem đến cho mình biết bao niềm vui, và hình thành cho mình một cách sống ngay cả khi mình không còn mang chức danh L&D nữa. Phiên bản cò học version 1.0 từ 2022 đến nay đã 3 năm và cũng có nhiều cập nhật, nên hôm nay mình viết vài dòng ở đây để ghi lại những điểm mới ở phiên bản 2.0 này.
1. Giả định về việc học
Việc học với mình, dựa trên một niềm tin mang tính nền tảng:
Mọi người, mọi thứ đều có thể trở thành phiên bản tốt hơn của chính họ.
Giả định này nghe có vẻ hiển nhiên, nhưng nó kéo theo rất nhiều câu hỏi:
“Trở thành phiên bản tốt hơn” nghe thì hay, nhưng nếu không thay đổi thì sao? Nếu mình hài lòng với phiên bản hiện tại của chính mình, liệu còn cần học nữa không?
Khi ta đòi hỏi một phiên bản tốt hơn, có phải ta đang không hài lòng với hiện tại? Mà tốt hơn là sao, có khi nào nghĩ tốt hơn mà hóa ra tệ hơn không?
Và nếu thay đổi là cần thiết, vậy bao lâu thì nó mới xảy ra?
Hai câu đầu là định tính, mình băn khoăn nhưng chỉ để trong lòng. Câu cuối có thể định lượng, nên nó cũng là một mối trăn trở mà nhiều người chia sẻ được. Mình có một câu chuyện nhỏ kể bạn nghe chơi:
Mình từng làm một phân tích về tần suất sử dụng thư viện trong công ty. Một nghiên cứu nhỏ thôi, xuất phát từ tò mò nhiều hơn là từ một “điểm đau” thực sự (pain point). Nhưng mình vẫn ghi nhớ số liệu ấy trong đầu, bởi nó là một “điểm đau” thực sự. Hai năm sau, một thành viên Ban Giám đốc bất ngờ hỏi về nó. Mình có thể trả lời ngay lập tức, và khoảnh khắc đó, mình thấy thỏa mãn: “Mình đã sẵn sàng cho câu hỏi này từ lâu.” Nhưng đồng thời, cũng có chút hụt hẫng: “Tại sao phải mất tận 2 năm để có người đủ tầm ảnh hưởng quan tâm đến nó?“
Bạn nghĩ sao?
Việc học và việc cải tiến luôn là một quá trình dài. Đôi khi (và nhiều khi), kết quả không đến ngay lập tức. Đôi khi (và nhiều khi), ta phải chờ rất lâu để những nỗ lực của mình được chú ý. Nhưng 5,5 năm làm L&D hình thành cho mình thói quen học tập như tập thể dục, dù không thấy lợi ích ngay lập tức, nhưng giúp mình duy trì sức bền để chuẩn bị cho những điều sắp đến
(Xin thú thiệt là mình thích tập thể dục não, chứ thể dục tay chân mình vẫn là một con sâu lười :P)
2. Chuyển nghề không phải đổi chức danh, mà là đổi vấn đề
Tháng 3/2022, mình tìm ra một từ để mô tả công việc L&D, như một cách thật đẹp để đóng gói lại hành trình hơn nửa thập niên. Tháng 11/2022, mình chuyển sang một lĩnh vực mới, Data Analyst. Và tháng 3/2025, là Business Analyst.
Nhưng mình không chuyển nghề vì muốn làm điều gì khác biệt hoàn toàn (như nhiều bạn và anh chị cảm thán khi mình nói mình chuyển nghề: “Em bỏ nghề L&D à/ Em bỏ HR à”). Mình chỉ muốn giải quyết vấn đề ở một cấp độ khác: những vấn đề lớn hơn, đa dạng hơn, và có nhiều cơ hội nghề nghiệp hơn.
Nếu trước đây mình phân tích nhu cầu học tập của nhân viên, thì bây giờ mình phân tích xu hướng vận hành và hiệu suất của tổ chức.
Nếu trước đây mình tạo động lực học tập, thì bây giờ mình tạo động lực ra quyết định dựa trên dữ liệu.
Nếu trước đây mình giúp một nhân viên hay một nhóm nhân viên học tốt hơn, thì bây giờ mình giúp một tổ chức học hỏi từ chính dữ liệu của họ.
Cốt lõi vẫn vậy: trao quyền ra quyết định, giúp những người ra quyết định tự tin hơn, giúp quá trình ra quyết định rõ ràng hơn.
3. Làm một người học trọn đời là làm gì?
Có một thời gian, cụm từ lifelong learner được truyền thông tung hô mạnh mẽ, như một chiến lược để thích ứng với những thay đổi trên thị trường lao động. Là một người làm đào tạo, mình rất thích khái niệm này.
Nhưng mình cũng nghĩ: Tại sao chỉ có “learner”? Liệu phong trào “tự lực” (self-help) có đang quá đề cao nỗ lực cá nhân mà bỏ qua yếu tố môi trường?
Nghĩ nhiều nhưng vẫn phải hành động. Với tư cách một cá nhân, mình có thể làm gì?
Hiểu mình:
Biết được mình có bao nhiêu nguồn lực, bao nhiêu mối ưu tiên.
Biết giới hạn của mình: Mỗi ngày chỉ có 24 giờ, mỗi người chỉ có một cơ thể. Deadline nào cũng có thể dời, trừ deadline thực sự (mình lặp lại câu này rất nhiều lần). Thế nên phải học cách nói không, đừng để bản thân kiệt sức.
Sống trong hiện tại:
Nếu không thể dự đoán quá xa, ít nhất cũng nên biết hiện tại mình đang làm gì. Những tổ chức mình đang làm việc cùng cũng cần điều đó. Họ cần mô tả thế giới họ đang sống và việc họ đang làm được rõ ràng hơn, để tránh lặp lại những sai lầm hiển nhiên của quá khứ.
Chuẩn bị cho tương lai
Vẫn phải vui với hiện tại, nhưng ngay lúc vui nhất cũng phải dành một chút lắng lo về tương lai. Quan sát liên tục, bởi môi trường luôn thay đổi.
Nếu không thể tạo ra cơ hội, mình vẫn phải chuẩn bị sẵn sàng để nắm bắt cơ hội khi nó đến. (Mình thích cuốn “Bí mật của may mắn” :D) Vì cả ngàn cơ hội lướt qua, nhưng ai đủ năng lực mới có thể nắm bắt.
Dư thừa có thể là lãng phí, mà cũng có thể là dự phòng. Xây cái kho cả trăm công cụ có vẻ lãng phí, nhưng lúc cần có thể lôi ra được một cái mà xài đã là tốt rồi, còn hơn không có gì trong tay. Và biết đâu cái này không hiệu quả, mình có sẵn cái khác mà lôi ra xài. (Đâu phải tự nhiên mình có 2 tay 2 chân, 2 quả thận, 2 lá phổi?)
4. Chuyện của mình, bớt so với người
Nếu hôm nay mình mệt quá, nghỉ một chút cũng không sao.
Công thức thành công của người khác, chưa chắc đã áp lên mình được.
Nhiều khi để cố gắng sống qua ngày thôi thì một người nào đó đã phải vận toàn lực của họ rồi. Không phải ai cũng có đủ nguồn lực để lo cho tương lai, nên đừng trách ai vì họ không thể làm thế này, thế nọ. (Bạn có thể đọc thêm các bài phản biện về thí nghiệm kẹo Marshmallow).
Mình hay tự an ủi rằng: “Ở quá khứ, mình đã ra những quyết định tốt nhất có thể tại thời điểm đó”. Vỗ vai mình một cái, tự khen mình, và bước tiếp.
Lần chuyển ngành đầu tiên thật đáng sợ. Từ L&D sang DA, mình mất 3 năm. Từ L&D sang BA, mình mất 5 năm, nhưng lần này đỡ đáng sợ hơn một chút, vì mình có vẻ đã biết quy trình rồi 😛 và từ DA sang BA mình chỉ mất có 2.5 năm thôi.
Mình vẫn sợ mỗi lần phải học điều mới, nhưng không đông cứng nữa. Sợ thì vẫn sợ, học thì vẫn học thôi. Và trên con đường học tập đó có nhiều người đi cùng lắm.
Thay đổi thì tất nhiên sẽ có hoảng loạn. Nhưng rồi mình sẽ quen.
Bị tụt lại một chút cũng không sao, thế giới này đủ rộng để có chỗ cho tất cả.
Và dù có bao nhiêu băn khoăn, bao nhiêu dâu bể, chúng mình rồi cũng sẽ sống sót thôi.
Khi mới đi làm, có những lúc mình phải OT triền miên. Công việc thì chậm, chất lượng kém, càng làm càng sai, lại phải giải trình và chỉnh sửa, khiến mình càng thêm áp lực. Mọi chuyện chỉ thay đổi khi một người chị gợi ý: “Em phải ước lượng được công việc của mình tốn bao nhiêu thời gian, công sức, để những người làm chung có thể hỗ trợ em.” Đây là lần đầu tiên mình tiếp xúc với khái niệm workload estimation.
Từ ước lượng việc mình, đến ước lượng việc của team
Ban đầu, mình bắt đầu bằng việc ghi lại danh sách các đầu việc, theo dõi và ghi chép thời gian hoàn thành từng công việc. Sau đó, mình so sánh với số giờ làm việc tiêu chuẩn (22 ngày/tháng cho tuần làm 5 ngày). Kết quả cho thấy, mình đang làm việc quá tải tới 150% so với tiêu chuẩn, và với dữ liệu này, mình thuyết phục được team cho tuyển thêm một intern.
Khi chuyển sang công ty mới, mình lại thực hiện workload estimation nhưng ở cấp độ của toàn team TA. Ban đầu mình gợi ý mọi người ghi lại danh sách công việc và bấm giờ bằng Toggle, nhưng team cho rằng có rất nhiều việc “không tên” và tốn ít thời gian quá (ví dụ, hỏi thăm hiring manager về việc review CV) thì không đáng để ghi xuống. Mình nghĩ đến việc phải làm cho việc ghi chép này dễ dàng hơn, bằng cách mô tả được tất cả các đầu việc mà team đang làm. Mình dựa trên một lý thuyết cơ bản nhất trong Nhân sự, là vòng đời nhân viên (employee lifecycle) và mô hình IPO (Input – Process – Output) để định vị vai trò, trách nhiệm của team TA trong từng giai đoạn của vòng đời đó trong mối quan hệ với các bên liên quan. Từ đó, mình liệt kê được một danh sách cơ bản các đầu việc của team TA để các bạn leader có thể điền thông tin, chỉnh sửa và bổ sung. Khối lượng công việc (tuyển được bao nhiêu người, trong bao lâu, từ các kênh nào…) được tham khảo từ dữ liệu thực tế từ dashboard (như hiring funnel) kết hợp với input từ các bạn trong team. Từ đó, mình xây dựng được ước lượng được thời gian mà team đang bỏ ra cho từng loại công việc. Kết quả là team được tái cấu trúc: một nhóm tập trung vào admin onboarding và chăm sóc trải nghiệm ứng viên, trong khi các recruiter chuyên tâm vào việc tìm người phù hợp.
Khi TA Manager hỏi mình rằng danh sách đầu việc mà team input được xây dựa trên template có sẵn hay tự xây, mình trả lời rằng đó là cách mình tự phát triển. Tuy nhiên, sau này khi học môn Định mức lao động, mình tình cờ nhận ra rằng cách làm của mình thực ra đúng phương pháp bài bản. Lần đó là mình hên, nhưng có học hành chỉn chu chắc chắn mình sẽ làm nhanh và chuẩn hơn với những từ khóa chuẩn mực để tham khảo, thay vì loay hoay thử và sai như vậy. Mình cũng rất vui là dựa vào quan sát và hiểu biết thực tế về lĩnh vực nhân sự, nên mình đã dựa trên những kiến thức quen thuộc với cách nghĩ của các bạn và nhận được sự tin tưởng từ các bên trong việc nhập dữ liệu vào.
Giữa mục tiêu và nguồn lực, tìm đâu ra động lực bớt lười?
Workload estimation không chỉ áp dụng trong công việc mà còn trong đời sống cá nhân. Một người bạn của mình từng chia sẻ về áp lực giữa việc kiếm sống, học hành để phát triển, và theo đuổi dự án riêng. Tất cả khiến bạn kiệt sức nhưng vẫn cảm thấy mình chưa làm đủ. Câu chuyện này đánh động tâm can mình, vì bản thân mình cũng có lúc rơi vào tình trạng tương tự. Càng mệt, mình lại càng nghĩ đến những việc chưa làm xong, như một vòng lặp không lối thoát.
Những lúc đó, mình cố gắng để những deadline, plan sang một bên, và ngồi xuống, tính toán lại nguồn lực của mình. Mình chỉ có một tấm thân này, một cuộc đời này, và mình không phải ba đầu sáu tay, mình cũng chỉ có 24h một ngày như bao người khác. Mình có trách nhiệm với bản thân và những người khác, có ước mơ trong tương lai, và có những vấn đề chưa giải quyết. Viết xuống những điều này trong một tờ giấy giúp mình có cảm giác kiểm soát hơn một chút, và chấp nhận rằng mình sẽ phải buông bỏ một số thứ, để làm sau hoặc giao cho ai đó làm giúp. Thay vì chỉ nhìn vào những mục tiêu không đạt được, mình tạo một mục “unplanned achievement” khi tổng kết năm. Nhờ đó, dù chỉ đạt 0.5/4 mục tiêu theo kế hoạch, mình vẫn nhận ra 5 thành tựu khác, đến từ niềm vui và những cơ hội ngẫu nhiên. Điều này giúp mình giảm áp lực và khơi lại động lực làm việc. Mình từng đọc ở đâu đó, rằng người ta đánh giá quá cao những việc có thể làm trong một năm, và đánh giá quá thấp những việc có thể làm trong 10 năm. Đã 10 năm trôi qua kể từ khi mình bắt đầu đi làm, và nhìn lại mình cảm thấy mình không giống bao nhiêu so với tưởng tượng khi ấy, nhưng là một phiên bản mà mình có thể tự hào mà nói với Giang tuổi 22 rằng hãy yên tâm, bạn đã chuẩn bị cho mình tốt quá rồi.
Niềm vui sắp xếp
Khi làm workload estimation cho bản thân vào đầu năm nay, mình nhận ra bản thân có xu hướng làm nhiều những đầu việc liên quan đến sắp xếp, lên kế hoạch. Mình yêu thích việc sắp xếp ở nhiều khía cạnh trong cuộc sống. Có ai ngờ, giữa muôn vàn những thứ mình học, mình làm, mình chơi, từ điều phối lớp học, chạy sự kiện, làm data, làm thủ công, vẽ vời, tâm hồn sắp xếp của mình như một dòng chảy xuyên suốt trong tất cả.
Khi làm data: việc tìm kiếm data provider, sắp xếp các nguồn dữ liệu, thiết kế data flow, modelling process, và viết mô tả về data (metadata) khiến mình hứng thú hơn cả trong số những công việc liên quan đến data.
Khi học vẽ: mình có thể không kiên nhẫn ngồi luyện vẽ dáng người, nhưng lại tò mò về việc có bao nhiêu cách giản lược hình dáng con người (người que, người bao, người sao, người bún đậu (bean pole)…) hay có bao nhiêu cách vẽ mắt 😀
Khi làm thủ công: mình có thể ngồi hàng giờ để sắp chỉ theo màu, dù không đủ kiên nhẫn thêu hết một hình nhỏ; có thể tìm hiểu về các loại kim móc trên thế giới và các kiểu móc, nhưng thứ lớn nhất mà mình từng móc là một bạn gấu bé xinh bằng lòng bàn tay 😛
Nhưng đây là điều đối nghịch: mình thấy vui khi mọi thứ ở đúng chỗ, nhưng về đời sống “vật chất” mình lại là đứa khá bừa bộn ở nhà, chỉ bật mode “phù thủy dọn dẹp” những lúc mình stress. Do đó, mình không thể trở thành Marie Kondo hay The Home Edit, nhưng mình muốn rủ rê bạn cùng dọn dẹp “đời sống số” của chúng ta. Bạn biết sao không, việc này sẽ giúp chúng ta chuẩn bị cho việc ứng dụng AI đó. Việc ứng dụng AI giống như nhà có một em bé tò mò, sẽ khám phá mọi ngóc ngách trong nhà. Nếu có cánh cửa nào đáng lẽ phải khóa mà không khóa, em bé sẽ vào và tiết lộ những điều không ngờ tới. Vì vậy, dọn dẹp dữ liệu sẽ giúp bạn chuẩn bị tốt để giảm thiểu rủi ro về an toàn bảo mật dữ liệu, đồng thời giúp bạn có những bộ dữ liệu tốt, cá nhân hóa để tạo những “trợ lý AI” có mức độ chuyên môn hóa cao cho bản thân.
Mình đã tạo một sự kiện hàng tháng vào thứ 7 thứ 2 của tháng (tức là từ hôm nay nè) để mọi người cùng nhau sắp xếp “đời sống số”. Tụi mình cùng dọn dẹp hén, có thể là kho ảnh trong điện thoại, album trên Facebook, friendlist, bookmark, folder Google Drive, iCloud, hay các trang trên Notion… Tụi mình sẽ cùng nhau coi thử lúc dọn dẹp có thể gặp những vấn đề gì, phân loại ra sao, back up thế nào…
Năm nay là năm thứ hai mình không phải là người đứng ra tổ chức ngày nhà giáo ở công ty.
Năm đầu tiên, mình có phần hơi tiếc nuối cái không khí bận rộn đó, nhưng công việc mới cuốn mình đi (mình đang bao biện, mình biết). Và tới năm thứ hai, mình nhìn các bạn đồng nghiệp cũ chuẩn bị, trong lòng mình dấy lên cảm giác cồn cào, như có ai đó đang thỏ thẻ: nè, nói gì đi.
Mình nghĩ cái khiến cho mình nhớ về ngày nhà giáo nhiều nhất là việc lên danh sách ai sẽ được tặng quà vào ngày nhà giáo. Đó là câu hỏi khó. Không giống như một trường học, vai trò “giáo” sẽ được chia đều cho tất cả mọi người. Chúng ta đồng thời là người học và cũng là người dạy. “Teacher” mang muôn vàn chức danh khác nhau: trainer, instructor, mentor, coach, facilitator… Chức danh mình thích nhất, chính là facilitator – người tạo thuận lợi.
Mất 5 năm để mình đúc rút được về công việc của mình khi đó: make learning happens/làm việc học xảy ra. Và sau đó, mình ra đi, thử sức với một vai trò khác: make things visible/làm mọi thứ lộ ra. Cả hai đều làm công việc tạo điều kiện để cho việc gì đó xảy ra. Vậy thì mình thử làm cho learning visible/làm cho việc học xuất hiện ra xem sao? Có 3 hình ảnh xuất hiện ra trong đầu mình về việc học: bục giảng, bàn học, và máy tính.
Bục giảng Hẳn chúng ta đã quen với hình ảnh này lắm lắm, đến mức nhắm mắt cũng có thể tưởng tượng cái bục giảng trước mắt, với một chiếc bảng to, một cái bệ nâng hẳn người giáo viên lên trên một bậc so với học sinh, và một đám học sinh chăm chú hướng mắt nhìn lên. Trông cũng giống như một buổi giảng ở nhà thờ, và trông cũng giống một buổi lễ tôn giáo. Người giáo viên ở đây thực sự có nhiều quyền lực. Một cái liếc mắt có thể khiến cho đám học trò bên dưới run rẩy. Và rất nhiều khi, mình có cảm giác người học trò ở đây biến mất. Việc trao đổi bị hạn chế tối đa. “Lớp ồn” là một câu chê rất nặng trong sổ đầu bài. Nói thật thà thì, mình không thích kiểu lớp học này. Nhưng thế mạnh của nó là gì? Khả năng phục vụ một nhóm người học đông đảo, trong điều kiện rất hạn chế.
Bàn Đây là hình ảnh mình gặp khi đi làm. Một bạn senior hướng dẫn cho một vài bạn junior. Cầm tay chỉ việc. Mình thích nó, và cho đến nay mình vẫn rất ưng kiểu học tập này. Ban đầu, bạn senior vẫn biết nhiều hơn bạn junior một chút. Nhưng qua thời gian, cả junior lẫn senior nay đã có thể cùng nhau thảo luận về một vấn đề. Sự chênh lệch quyền lực không còn lớn nữa. Và chúng ta có thể nói về chuyện này bằng câu kết trong “Chuyện kể về ba anh em của Beetle the Bard” mà mình yêu thích: “Họ cùng nhau rời đi như những người đồng đẳng ngang hàng”. Vấn đề? Khó standardize và scale up.
Máy tính Và đây là lúc người thầy biến mất. Người học tự chủ trên con đường khám phá của chính mình. Tài liệu học tập tách rời khỏi người truyền đạt, có một đời sống riêng. Người học nhận diện vấn đề, tự tìm giải pháp, và thảo luận với những người cùng chung vấn đề. Nó mệt, và chẳng có câu trả lời nào là đúng hay sai, chỉ là phù hợp hay không phù hợp. Vấn đề với cách học này? Chúng ta dễ lạc lối trong một biển thông tin. Và khi mệt quá, đôi khi ta ước có thánh phán cho rồi, hay ít nhất là ai đó ta biết chắc là hiểu vấn đề, nói cho ta nghe mình cần làm gì.
Sau khi viết về ba hình ảnh đó, mình lại có một hình ảnh khác trong đầu khi nghĩ về sự học: một chiếc ba lô. Đó là cách mình học từ vài năm nay, thông qua việc đi, quan sát, ghi chép, nói chuyện. Không có máy tính, không có bục giảng, không có bàn. Nghe chẳng giống học, giống đi chơi nhiều hơn. Nhưng ai nói đi chơi là không học?
Với bốn hình ảnh trên, có thể đưa ra quan sát rằng, người giáo viên rõ nét nhất là trên bục giảng, rồi bắt đầu mờ dần đi khi bước xuống bên chiếc bàn cạnh học sinh, khuất dần sau chiếc máy tính, và biến mất luôn khi xách ba lô lên; còn người học mỗi lúc lại một rõ nét hơn. Mình nghĩ đó là quá trình không thể đảo ngược, với việc thông tin đang chuyển từ tình trạng khan hiếm hay thừa mứa. Việc học không chỉ gói gọn trong nhà trường, hay bộ phận đào tạo, mà trở thành sự góp sức của tất cả những người liên quan, trong đó người học đóng vai trò chủ đạo còn những người khác bao gồm cả giáo viên đóng vai trò hỗ trợ. Điều đó sẽ dẫn tới một số tình huống toát mồ hôi sau:
Phụ huynh Ất: Trời ơi sao tui đưa con tới trường học rồi mà sao nó hư? Đi làm đã mệt rồi còn phải dạy con ư? Cô giáo: Chị ơi, đây là con chị mà, sao chị tống cho trường hết vậy?
Nhân viên Giáp: Ê công ty không có career map hay competency framework, mà có đi nữa cũng không hợp với tui. Nhân sự: Ủa sự nghiệp của bạn mà?
Sếp Mô: Tui muốn lập community of practice, nhưng mà phải có outcome theo đơn đặt hàng của công ty. Nhân sự: Nếu vậy anh lập task force chứ anh đừng làm community of practice chi, nó sai mục đích từ đầu rồi.
Sếp Tê: Tui quản lý kết quả nhưng mà sao tui đưa mấy cái hướng dẫn làm việc mà tụi nó không nghe, cứ thích làm theo ý mình Nhân viên: Ủa anh trao quyền cho người ta mà?
Phụ huynh Răng: Sao thầy cứ cho con tui học ba cái trò tư duy phản biện làm cái gì, về nhà tôi nói gì nó cũng nói lại, hở ra là cãi. Thầy giáo: @@
Học sinh Rứa: Mẹ ơi, mẹ cho con đi mấy khóa học tập trải nghiệm này nha. Cô nói đi chơi cũng là học á! Mẹ: Ủa nó đi chơi mà nó kêu nó học là ý làm sao? Lại còn tốn cả đống tiền nữa hả!!!
Mấy tình huống này mình lượm lặt trên báo, lẫn lấy từ trải nghiệm của chính mình. Liệt kê mấy cái đó để nói rằng, việc học có rất nhiều vấn đề, mà một phần lớn đến từ kì vọng khác nhau của các bên liên quan, lẫn thiếu thông tin về các mặt khác nhau của một giải pháp. Chúng ta khó mà kì vọng học sinh sáng tạo và tích cực, nhưng lại không được “cãi leo lẻo” khi ở nhà. Cũng rất khó để trải nghiệm cuộc sống nếu chỉ gói gọn trong bốn bức tường lớp học. Chi phí thì lại là một vấn đề khác mà mình không đủ dữ liệu lẫn kiến thức để bàn đến. Cũng không thể kì vọng công ty sẽ có tất cả mọi nguồn lực cần thiết cho việc học của nhân viên, mà chính nhân viên sẽ phải chủ động đề xuất, và đi kèm với nó là nguy cơ bạn ấy tìm thấy nơi học tập ở tổ chức khác. Mọi thứ đều có giá của nó, nên mình nghĩ chúng ta phải rất cẩn thận với những điều mình ao ước.
Từ bục giảng, đến chiếc bàn, chiếc máy tính, chiếc ba lô, bốn hình ảnh này tượng trưng cho con đường học tập của mình, và có lẽ cũng quen thuộc với nhiều người. Khi mô tả chúng, mình không có ý nói cái gì hay hơn cái gì, tất cả đều sẽ có chỗ phù hợp. Mình chỉ mong sẽ có nhiều hơn những người chịu ngồi xuống cùng nhau thảo luận, cùng xắn tay áo lên giải quyết một phần nhỏ của vấn đề, xem đó cũng có phần việc của mình thay vì nghĩ rằng chỉ là việc của người khác, và tôn trọng phạm vi công việc, chuyên môn của người khác.
Còn mình, vẫn chỉ là một đứa trẻ trên con đường học tập, ngồi làm tập làm văn mô tả chút chuyện xàm. Khi viết đến dòng này, mình lại nhớ đến những câu kết kinh điển: “Em hứa sẽ chăm chỉ, ngoan ngoãn học tập để ông bà ba mẹ thầy cô vui lòng”. Ôi, mình nên hứa gì? Hay mình hứa là sẽ nghiêm túc như một đứa con nít đang chơi nhé? Liệu ông bà ba mẹ thầy cô có vui lòng khi nghe câu hứa này không? Nghi là không quá, thiếu điều xách chổi rượt vì cái tội cà khịa, haha.
Năm nay là năm thứ hai mình không phải là người đứng ra tổ chức ngày nhà giáo ở công ty.
Năm đầu tiên, mình có phần hơi tiếc nuối cái không khí bận rộn đó, nhưng công việc mới cuốn mình đi (mình đang bao biện, mình biết). Và tới năm thứ hai, mình nhìn các bạn đồng nghiệp cũ chuẩn bị, trong lòng mình dấy lên cảm giác cồn cào, như có ai đó đang thỏ thẻ: nè, nói gì đi.
Mình nghĩ cái khiến cho mình nhớ về ngày nhà giáo nhiều nhất là việc lên danh sách ai sẽ được tặng quà vào ngày nhà giáo. Đó là câu hỏi khó. Không giống như một trường học, vai trò “giáo” sẽ được chia đều cho tất cả mọi người. Chúng ta đồng thời là người học và cũng là người dạy. “Teacher” mang muôn vàn chức danh khác nhau: trainer, instructor, mentor, coach, facilitator… Chức danh mình thích nhất, chính là facilitator – người tạo thuận lợi.
Mất 5 năm để mình đúc rút được về công việc của mình khi đó: make learning happens/làm việc học xảy ra. Và sau đó, mình ra đi, thử sức với một vai trò khác: make things visible/làm mọi thứ lộ ra. Cả hai đều làm công việc tạo điều kiện để cho việc gì đó xảy ra. Vậy thì mình thử làm cho learning visible/làm cho việc học xuất hiện ra xem sao? Có 3 hình ảnh xuất hiện ra trong đầu mình về việc học: bục giảng, bàn học, và máy tính.
Bục giảng Hẳn chúng ta đã quen với hình ảnh này lắm lắm, đến mức nhắm mắt cũng có thể tưởng tượng cái bục giảng trước mắt, với một chiếc bảng to, một cái bệ nâng hẳn người giáo viên lên trên một bậc so với học sinh, và một đám học sinh chăm chú hướng mắt nhìn lên. Trông cũng giống như một buổi giảng ở nhà thờ, và trông cũng giống một buổi lễ tôn giáo. Người giáo viên ở đây thực sự có nhiều quyền lực. Một cái liếc mắt có thể khiến cho đám học trò bên dưới run rẩy. Và rất nhiều khi, mình có cảm giác người học trò ở đây biến mất. Việc trao đổi bị hạn chế tối đa. “Lớp ồn” là một câu chê rất nặng trong sổ đầu bài. Nói thật thà thì, mình không thích kiểu lớp học này. Nhưng thế mạnh của nó là gì? Khả năng phục vụ một nhóm người học đông đảo, trong điều kiện rất hạn chế.
Bàn Đây là hình ảnh mình gặp khi đi làm. Một bạn senior hướng dẫn cho một vài bạn junior. Cầm tay chỉ việc. Mình thích nó, và cho đến nay mình vẫn rất ưng kiểu học tập này. Ban đầu, bạn senior vẫn biết nhiều hơn bạn junior một chút. Nhưng qua thời gian, cả junior lẫn senior nay đã có thể cùng nhau thảo luận về một vấn đề. Sự chênh lệch quyền lực không còn lớn nữa. Và chúng ta có thể nói về chuyện này bằng câu kết trong “Chuyện kể về ba anh em của Beetle the Bard” mà mình yêu thích: “Họ cùng nhau rời đi như những người đồng đẳng ngang hàng”. Vấn đề? Khó standardize và scale up.
Máy tính Và đây là lúc người thầy biến mất. Người học tự chủ trên con đường khám phá của chính mình. Tài liệu học tập tách rời khỏi người truyền đạt, có một đời sống riêng. Người học nhận diện vấn đề, tự tìm giải pháp, và thảo luận với những người cùng chung vấn đề. Nó mệt, và chẳng có câu trả lời nào là đúng hay sai, chỉ là phù hợp hay không phù hợp. Vấn đề với cách học này? Chúng ta dễ lạc lối trong một biển thông tin. Và khi mệt quá, đôi khi ta ước có thánh phán cho rồi, hay ít nhất là ai đó ta biết chắc là hiểu vấn đề, nói cho ta nghe mình cần làm gì.
Sau khi viết về ba hình ảnh đó, mình lại có một hình ảnh khác trong đầu khi nghĩ về sự học: một chiếc ba lô. Đó là cách mình học từ vài năm nay, thông qua việc đi, quan sát, ghi chép, nói chuyện. Không có máy tính, không có bục giảng, không có bàn. Nghe chẳng giống học, giống đi chơi nhiều hơn. Nhưng ai nói đi chơi là không học?
Với bốn hình ảnh trên, có thể đưa ra quan sát rằng, người giáo viên rõ nét nhất là trên bục giảng, rồi bắt đầu mờ dần đi khi bước xuống bên chiếc bàn cạnh học sinh, khuất dần sau chiếc máy tính, và biến mất luôn khi xách ba lô lên; còn người học mỗi lúc lại một rõ nét hơn. Mình nghĩ đó là quá trình không thể đảo ngược, với việc thông tin đang chuyển từ tình trạng khan hiếm hay thừa mứa. Việc học không chỉ gói gọn trong nhà trường, hay bộ phận đào tạo, mà trở thành sự góp sức của tất cả những người liên quan, trong đó người học đóng vai trò chủ đạo còn những người khác bao gồm cả giáo viên đóng vai trò hỗ trợ. Điều đó sẽ dẫn tới một số tình huống toát mồ hôi sau:
Phụ huynh Ất: Trời ơi sao tui đưa con tới trường học rồi mà sao nó hư? Đi làm đã mệt rồi còn phải dạy con ư? Cô giáo: Chị ơi, đây là con chị mà, sao chị tống cho trường hết vậy?
Nhân viên Giáp: Ê công ty không có career map hay competency framework, mà có đi nữa cũng không hợp với tui. Nhân sự: Ủa sự nghiệp của bạn mà?
Sếp Mô: Tui muốn lập community of practice, nhưng mà phải có outcome theo đơn đặt hàng của công ty. Nhân sự: Nếu vậy anh lập task force chứ anh đừng làm community of practice chi, nó sai mục đích từ đầu rồi.
Sếp Tê: Tui quản lý kết quả nhưng mà sao tui đưa mấy cái hướng dẫn làm việc mà tụi nó không nghe, cứ thích làm theo ý mình Nhân viên: Ủa anh trao quyền cho người ta mà?
Phụ huynh Răng: Sao thầy cứ cho con tui học ba cái trò tư duy phản biện làm cái gì, về nhà tôi nói gì nó cũng nói lại, hở ra là cãi. Thầy giáo: @@
Học sinh Rứa: Mẹ ơi, mẹ cho con đi mấy khóa học tập trải nghiệm này nha. Cô nói đi chơi cũng là học á! Mẹ: Ủa nó đi chơi mà nó kêu nó học là ý làm sao? Lại còn tốn cả đống tiền nữa hả!!!
Mấy tình huống này mình lượm lặt trên báo, lẫn lấy từ trải nghiệm của chính mình. Liệt kê mấy cái đó để nói rằng, việc học có rất nhiều vấn đề, mà một phần lớn đến từ kì vọng khác nhau của các bên liên quan, lẫn thiếu thông tin về các mặt khác nhau của một giải pháp. Chúng ta khó mà kì vọng học sinh sáng tạo và tích cực, nhưng lại không được “cãi leo lẻo” khi ở nhà. Cũng rất khó để trải nghiệm cuộc sống nếu chỉ gói gọn trong bốn bức tường lớp học. Chi phí thì lại là một vấn đề khác mà mình không đủ dữ liệu lẫn kiến thức để bàn đến. Cũng không thể kì vọng công ty sẽ có tất cả mọi nguồn lực cần thiết cho việc học của nhân viên, mà chính nhân viên sẽ phải chủ động đề xuất, và đi kèm với nó là nguy cơ bạn ấy tìm thấy nơi học tập ở tổ chức khác. Mọi thứ đều có giá của nó, nên mình nghĩ chúng ta phải rất cẩn thận với những điều mình ao ước.
Từ bục giảng, đến chiếc bàn, chiếc máy tính, chiếc ba lô, bốn hình ảnh này tượng trưng cho con đường học tập của mình, và có lẽ cũng quen thuộc với nhiều người. Khi mô tả chúng, mình không có ý nói cái gì hay hơn cái gì, tất cả đều sẽ có chỗ phù hợp. Mình chỉ mong sẽ có nhiều hơn những người chịu ngồi xuống cùng nhau thảo luận, cùng xắn tay áo lên giải quyết một phần nhỏ của vấn đề, xem đó cũng có phần việc của mình thay vì nghĩ rằng chỉ là việc của người khác, và tôn trọng phạm vi công việc, chuyên môn của người khác.
Còn mình, vẫn chỉ là một đứa trẻ trên con đường học tập, ngồi làm tập làm văn mô tả chút chuyện xàm. Khi viết đến dòng này, mình lại nhớ đến những câu kết kinh điển: “Em hứa sẽ chăm chỉ, ngoan ngoãn học tập để ông bà ba mẹ thầy cô vui lòng”. Ôi, mình nên hứa gì? Hay mình hứa là sẽ nghiêm túc như một đứa con nít đang chơi nhé? Liệu ông bà ba mẹ thầy cô có vui lòng khi nghe câu hứa này không? Nghi là không quá, thiếu điều xách chổi rượt vì cái tội cà khịa, haha.
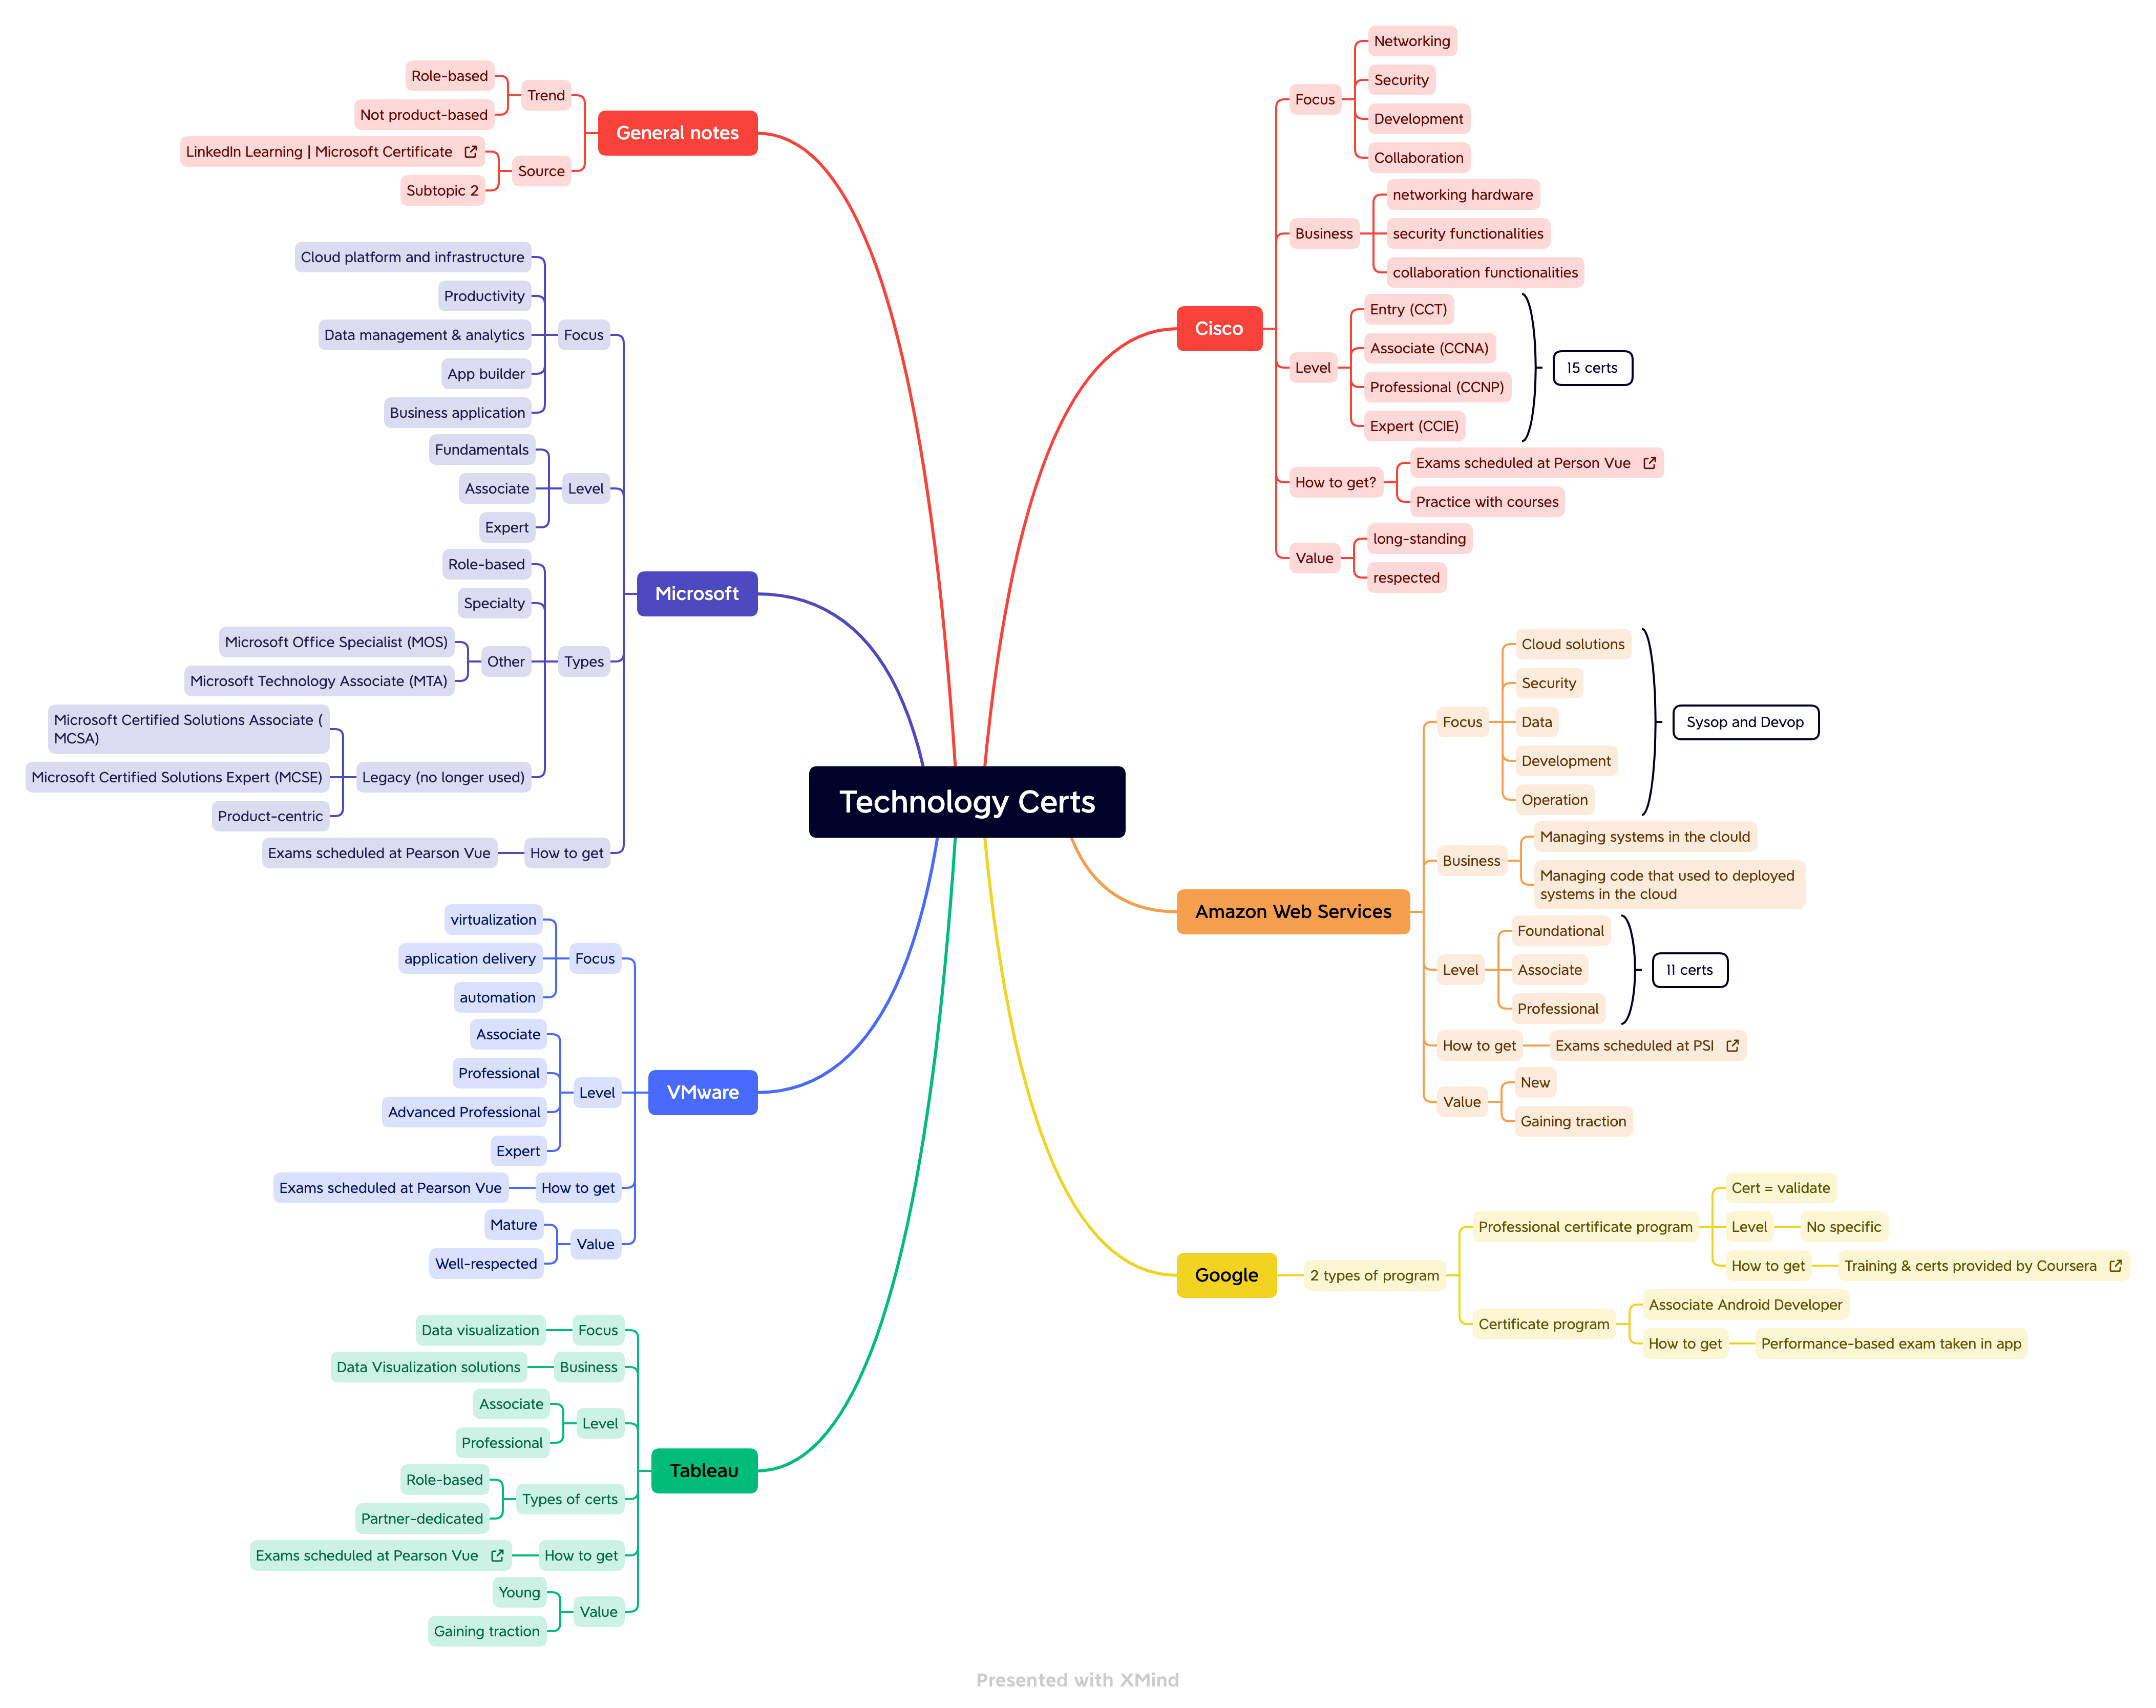
Mindmap trên được tổng hợp từ một phần trong khóa học giới thiệu về các chứng chỉ của Microsoft. Đánh giá chung của mình là:
Xu hướng hiện nay là bớt các chứng chỉ product-based, nhiều chứng chỉ role-based. Tuy nhiên nói gì thì nói, công cụ được dùng để minh họa vẫn là đồ của nhà đó thôi 😀
Microsoft gần như trận địa nào cũng góp mặt, cập nhật liên tục đến mức khó mà theo cho kịp.
Google thiên về hướng tổng quan, sơ sơ. Học miễn phí (dạng audit) trên một nền tảng đã quen thuộc như Coursera là một hướng rất mở cho anh em tiếp cận. Giá lấy chứng chỉ cũng phải chăng.
Amazon Web Services đang được anh em IT quanh mình rất được ưu ái.
Cisco, VMware => ???
Phần kế mình sẽ đi tổng hợp các chứng chỉ dành cho nhóm ngành Data 😀
Tại Việt Nam, việc trúng tuyển vào một trường đại học danh tiếng là một mốc quan trọng để có được một sự nghiệp thành công, đặc biệt là đối với những gia đình đến từ nông thôn hay có hoàn cảnh khó khăn. Hình thức thi tuyển vào đại học khác nhau tùy trường và tùy năm. Từ năm 2017 đến nay thì có thể kể đến:
Sử dụng điểm của kì thi Trung học phổ thông quốc gia
Xét tuyển thẳng
Xét học bạ
Kì thi riêng (ví dụ: Kì thi năng lực của nhóm Đại học Quốc gia TPHCM)
Em gái của mình hoàn thành chương trình phổ thông vào năm nay và dự định sẽ tiếp tục học đại học. Em đã tham gia một số kì thi riêng (kì thi năng lực của DH Quốc gia), nhưng chưa đậu vào trường em yêu thích, nên điểm của kì thi THPT Quốc gia là phương án chính để xét tuyển vào đại học của em. Đây cũng là hình thức được nhiều trường sử dụng để tuyển sinh nhất, cụ thể, thí sinh sẽ đăng kí nguyện vọng vào khoảng tháng 3, thi kì thi này vào khoảng tháng 7, có điểm vào tháng 8 và thay đổi nguyện vọng vào cuối tháng 8. Các nguyện vọng được xét từ trên xuống, nếu đậu nguyện vọng đầu thì không xét các nguyện vọng sau, nếu không đậu thì tiếp tục xét các nguyện vọng tiếp theo.
Vào tháng 3, em mình đã đăng kí 10 nguyện vọng, và sau khi biết điểm thi vẫn được điều chỉnh tối đa 3 lần nữa. Câu hỏi đặt ra là:
Ẻm có khả năng đậu nguyện vọng nào, dựa trên điểm thi THPT Quốc gia?
Làm thế nào để tối đa khả năng em sẽ đậu vào trường em mong muốn?
Để trả lời câu hỏi này, mình đã làm những bước như sau:
Bước 1: Hệ thống hóa:
Mình có những dữ liệu nào?
Điểm của em mình
Các tổ hợp dùng để xét tuyển
Đề án tuyển sinh của các trường, trong đó có số chỉ tiêu tuyển sinh dự kiến theo từng phương thức tuyển sinh, mình chỉ quan tâm đến số chỉ tiêu cho phương thức xét điểm thi THPT Quốc gia thôi
Phổ điểm năm nay
Điểm trúng tuyển các năm trước
Các đánh giá về thị trường lao động, ngành “hot”
Các đánh giá về trường đại học, dự kiến điểm tuyển sinh
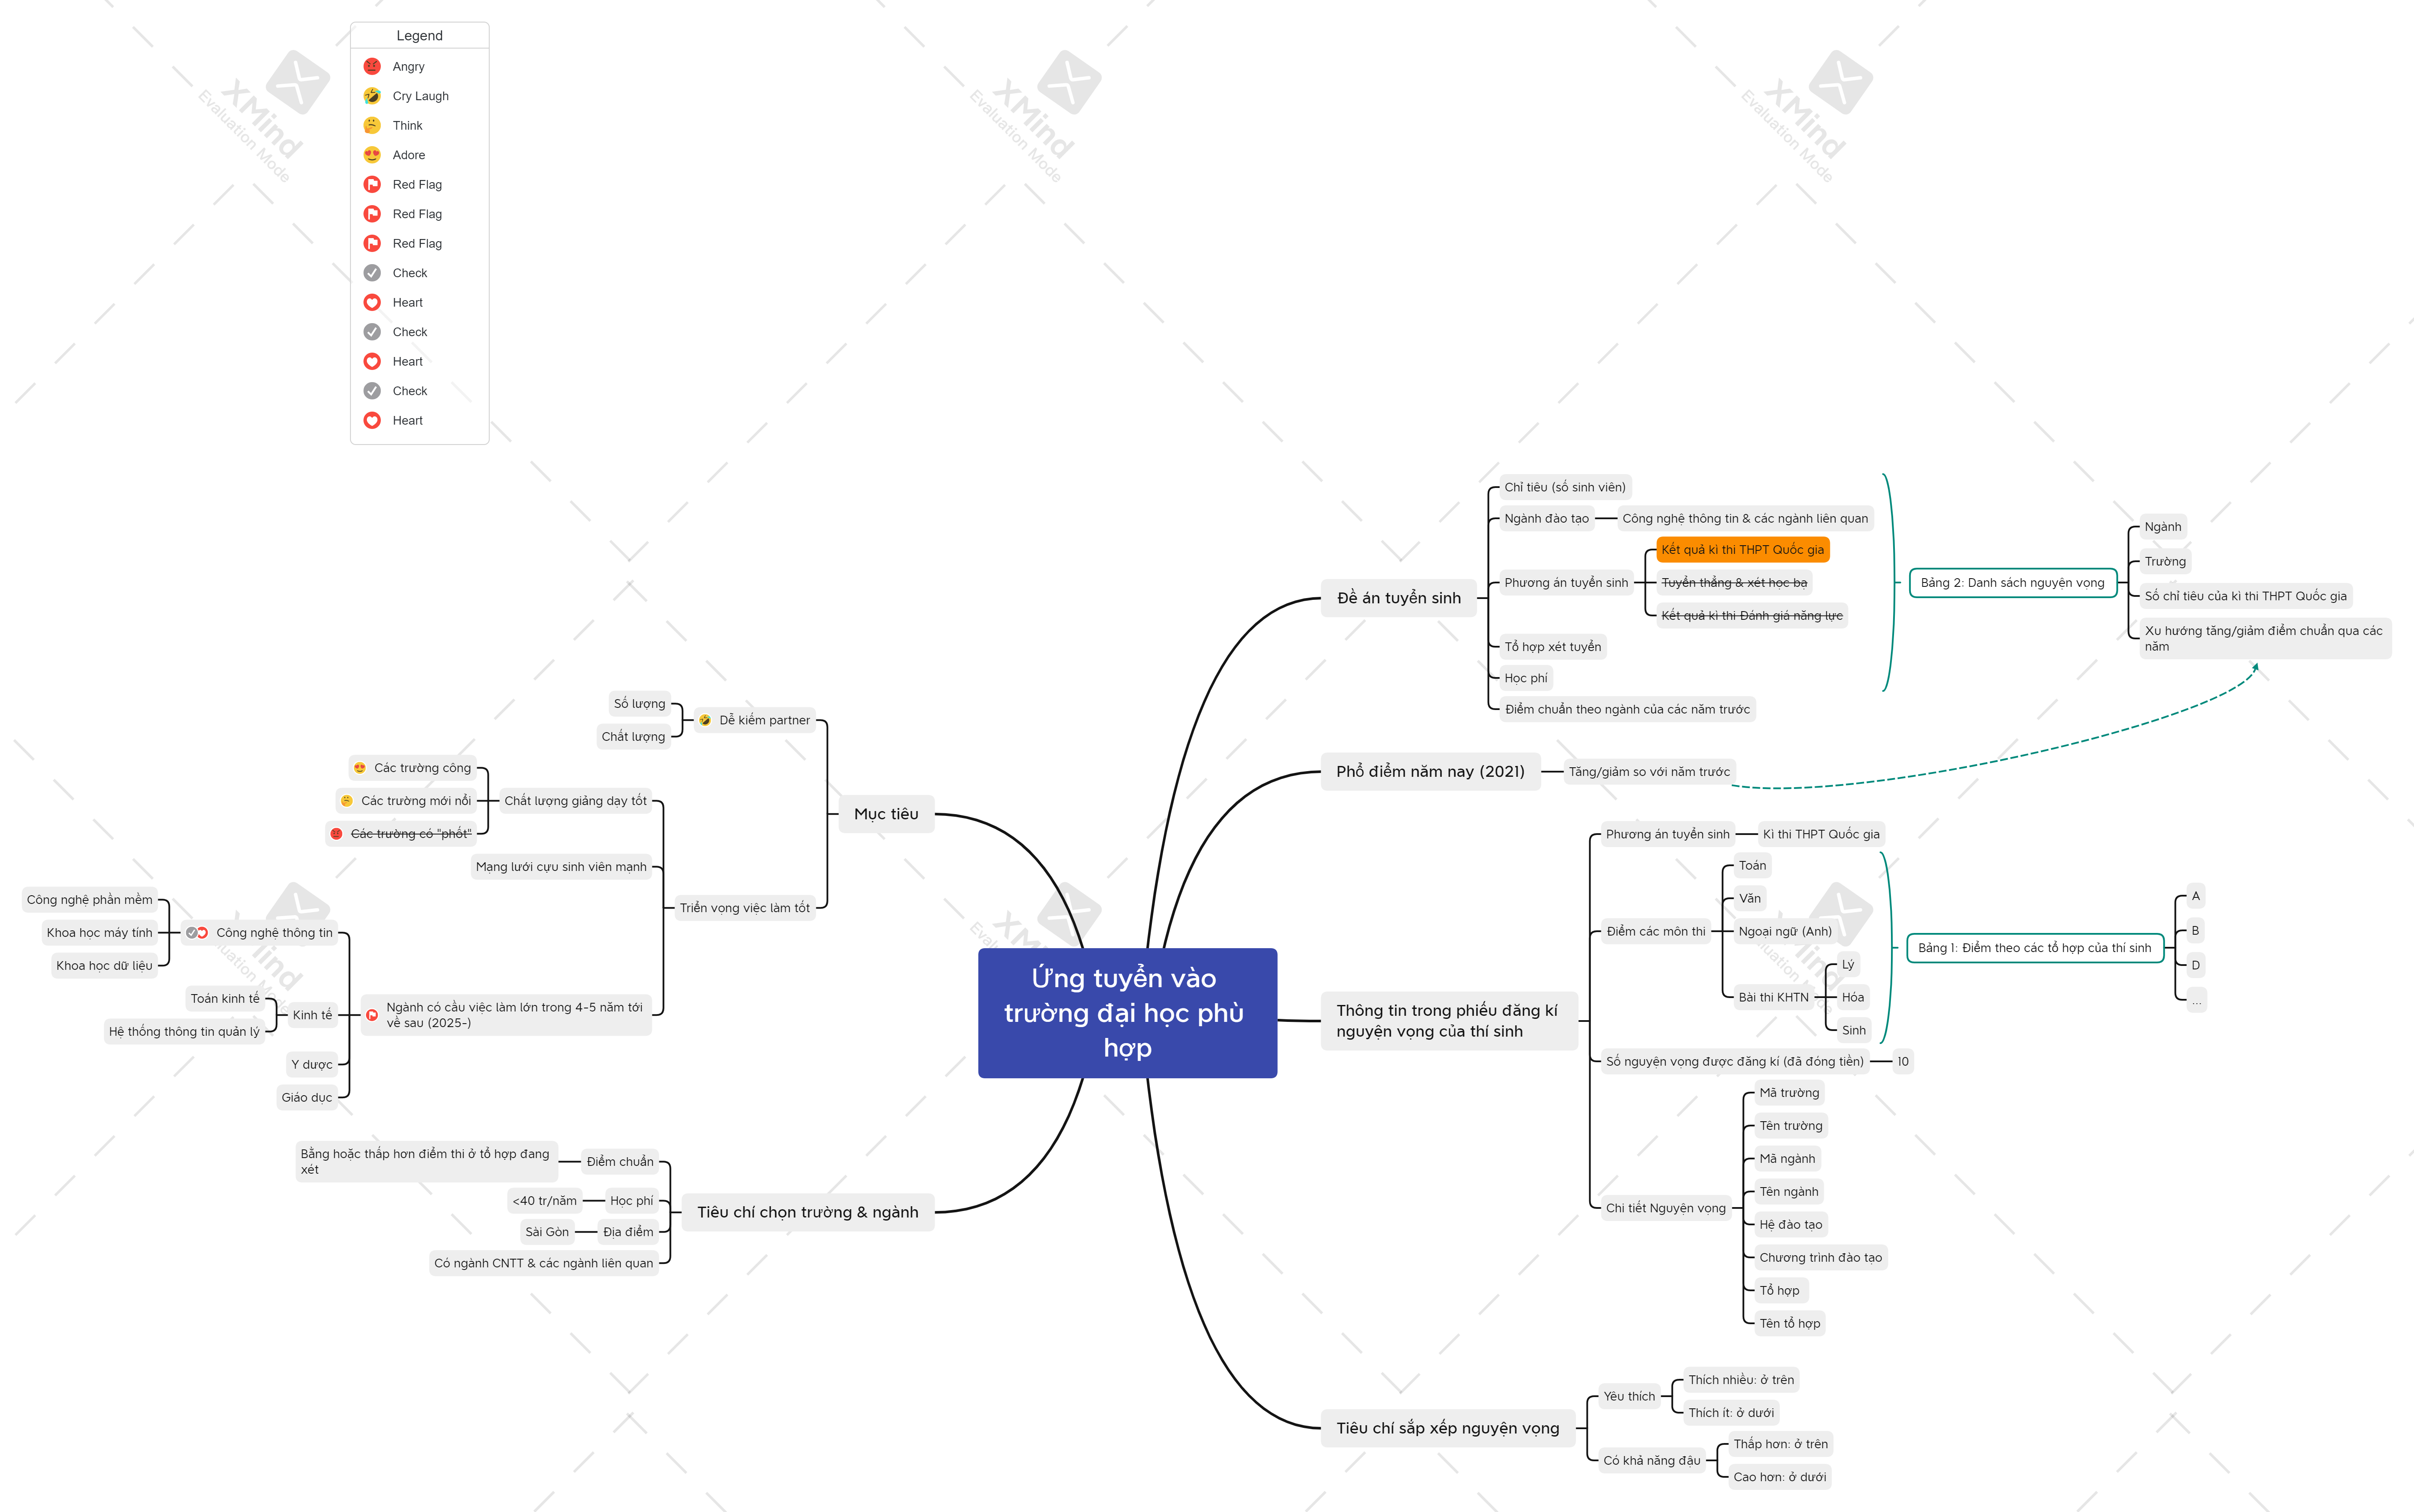
Mình sử dụng mindmap để hệ thống lại một số thông tin về bài toán này như bên dưới:
Bước 2: Tìm hiểu về business logic:
Tới đây, mình xin phép thống nhất thuật ngữ theo cách mình hiểu (chưa chắc đã là từ ngữ chuẩn theo văn bản chính thức):
Nguyện vọng: bao gồm ngành + trường + hình thức đào tạo, được đại diện bằng Mã ngành + Mã trường + Mã tổ hợp xét tuyển. Tuy trong ngôn ngữ bình dân, ta thường nghe “đậu trường đại học X”, nhưng đây là một thuật ngữ không chính xác do trong mỗi trường có nhiều ngành với điểm chuẩn rất khác nhau.
Tổ hợp: thường là một tập hợp 3 môn thi, kí hiệu bằng 1 chữ cái và 2 số. Ví dụ: A00: Toán, Lý, Hóa; D01: Toán, Văn, Anh văn… Các nguyện vọng có thể được xét tuyển bằng điểm của nhiều tổ hợp. Một số trường sẽ có quy định đặc biệt cho điểm tổ hợp được xét tuyển, ví dụ như nhân hệ số 2 cho một môn nào đó.
Điểm chuẩn: là điểm tối thiểu mà thí sinh phải đạt để được nhận vào học ngành đó tại trường.
Ngành đào tạo: là những ngành mà trường sẽ mở trong năm nay, mỗi ngành có chỉ tiêu tuyển sinh dự kiến. Với mỗi ngành đào tạo, các trường có thể xét tuyển bằng nhiều tổ hợp. Để tối đa khả năng được nhận, mình sẽ liệt kê điểm tất cả các tổ hợp mà em mình có, ứng với các tổ hợp mà ngành đó xét tuyển, và lấy điểm của tổ hợp nào cao nhất.
Nói ngắn gọn, trong trường hợp thông thường, chỉ sử dụng điểm để xét tuyển, không có tiêu chí phụ, việc đậu một nguyện vọng phụ thuộc vào:
Điểm của thí sinh theo các tổ hợp xét tuyển
Số lượng thí sinh nộp hồ sơ vào ngành đó của trường, theo từng tổ hợp
Điểm của các thí sinh nộp hồ sơ vào ngành đó của trường, theo từng tổ hợp
Số chỉ tiêu tuyển sinh ngành đó của trường
Mình chỉ có dữ liệu 1 và 4, còn 2 và 3 là trường cũng chỉ biết ngay trước khi quyết định điểm chuẩn, nên mình chọn cách dự báo dựa trên điểm chuẩn các năm trước, với giả định là nếu các yếu tố liên quan đến quá trình tuyển sinh không đổi, thì điểm chuẩn sẽ như năm trước:
đề thi có độ khó tương đương năm trước & các thí sinh có trình độ tương đương năm trước
số lượng chỉ tiêu giữ nguyên
số hồ sơ nộp vào ngành đó giữ nguyên
Tuy nhiên đời đâu có dễ ăn vậy:
Với các ngành “hot”, số lượng thí sinh nộp hồ sơ sẽ tăng cao => điểm chuẩn tăng
Nếu đề thi năm nay dễ hơn các năm trước, hoặc năng lực của thí sinh năm nay tốt hơn các năm trước, điểm thi sẽ tăng => điểm chuẩn tăng
Do đó, mình sẽ lấy điểm chuẩn 3 năm vừa rồi (2018, 2019, 2020), tính tốc độ tăng/giảm điểm chuẩn của nhóm ngành đó, và xây dựng 3 kịch bản điểm chuẩn năm nay:
Với ngành ổn định:
Max = max điểm 3 năm + max tốc độ tăng
Average = average điểm 3 năm + average tốc độ tăng 3 năm.
Min = min điểm 3 năm + min tốc độ tăng 3 năm
Với ngành hot:
Max = điểm max 3 năm + max tốc độ tăng
Average = điểm max 3 năm + average tốc độ tăng 3 năm.
Min = điểm max 3 năm + min tốc độ tăng 3 năm
Mình cũng xem phổ điểm của các tổ hợp năm nay xem số lượng thí sinh trong khoảng điểm mà các trường chấp nhận có tăng-giảm so với năm ngoái thế nào, nhưng mình chưa đủ khả năng để xét mối liên hệ của nó với sự tăng-giảm điểm chuẩn, nên mình tạm bỏ qua.
Bước 3: Xây dựng mô hình tính toán
Mình liệt kê các dữ liệu cần so sánh, cách tính toán từng mục, rồi tạo 1 file Google Sheets, gồm:
Bảng điểm theo tổ hợp
Phân tích nguyện vọng
Bước 4: Thu thập thông tin & tính toán
Liệt kê danh sách các ngành mà em mình quan tâm (Công nghệ thông tin & các ngành liên quan), và các trường có đào tạo ngành đó trong năm 2021. Chỗ này cần chút kinh nghiệm về ngành để mở rộng danh sách lựa chọn, vì với các bé thì đa phần chỉ biết công nghệ thông tin là công nghệ thông tin, không biết các ngành liên quan (công nghệ phần mềm, khoa học máy tính, hệ thống thông tin quản lý, khoa học dữ liệu, mở rộng ra thêm xíu thì ngành kinh tế ứng dụng, toán kinh tế làm CNTT cũng rất ok, chương trình học cũng có dạy code…)
Điền điểm chuẩn 3 năm vừa rồi. Lưu ý là có một số trường có cách tính điểm chuẩn theo tổ hợp hơi khác (nhân hệ số môn nào đó chẳng hạn), cần đọc kĩ.
Tính tốc độ tăng/giảm điểm chuẩn qua từng năm (điểm năm sau – điểm năm trước)
Tính điểm chuẩn dự kiến theo 3 kịch bản min, max, avg. Em mình chọn cái ngành hơi hot (CNTT), nên mình dùng kịch bản ngành hot.
Điền điểm của em mình, tính ra điểm để xét tuyển (có cộng ưu tiên) theo từng tổ hợp mà trường có tuyển cho ngành đó, đánh dấu tổ hợp có điểm cao nhất bằng Conditional Formating.
Điền thêm vài thông tin để hỗ trợ ra quyết định: Số chỉ tiêu tuyển sinh bằng hình thức điểm kì thi THPT Quốc gia, Học phí, alumni network…
Bước 5: Đánh giá
Mình đối chiếu điểm của em mình với điểm chuẩn dự kiến ở từng nguyện vọng theo kịch 3 kịch bản, và cũng đánh dấu khả năng đậu/rớt theo từng kịch bản bằng Conditional Formatting (rớt: đỏ, đậu: xanh). Nếu trong cả 3 kịch bản đều rớt, nguyện vọng đó bị loại. Nếu đậu ở kịch bản min, cân nhắc giữ lại.
Một số trường mà tụi mình quyết định bỏ ra khỏi danh sách vì điểm cao quá tầm với:
Tự nhiên
Bách khoa
Kinh tế
Công nghệ thông tin
Học viện Bưu chính viễn thông
Một số trường mới xuất hiện:
Sư phạm: Ngành Công nghệ thông tin, thuộc khoa Toán Tin
Quốc tế: Ngành Khoa học dữ liệu
Bước 6: Ra quyết định
Bước này là sắp xếp thứ tự nguyện vọng và đổi trong phiếu đăng kí. Có 2 tiêu chí: độ yêu thích & khả năng đậu.
Các nguyện vọng đầu: độ yêu thích cao, khả năng đậu thấp.
Các nguyện vọng giữa: độ yêu thích trung bình, khả năng đậu cao.
Các nguyện vọng cuối: khả năng đậu cao, độ yêu thích thấp.
Phù, đến đây thì mình cũng đã hỗ trợ em mình đổi nguyện vọng xong rồi, giờ đang chờ điểm chuẩn. Hi vọng ẻm sẽ đậu vào ngành ẻm yêu thích, để hỗ trợ bà chị chuẩn hóa cái quy trình củ chuối này.
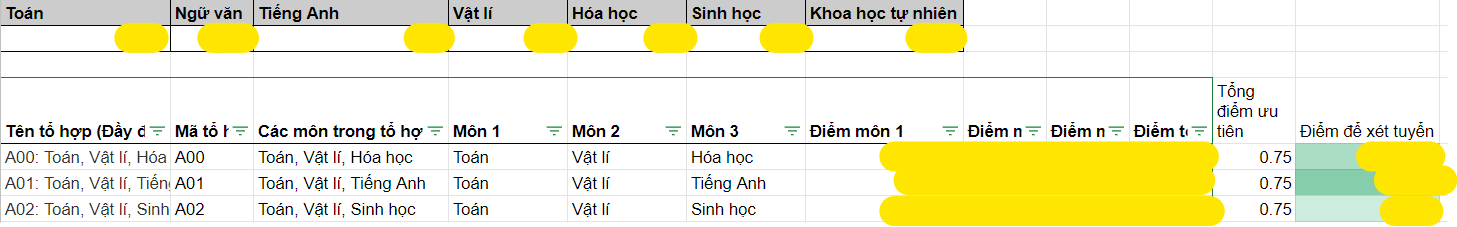
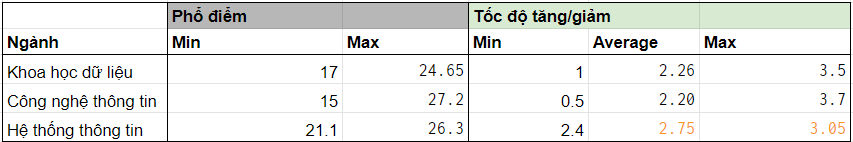
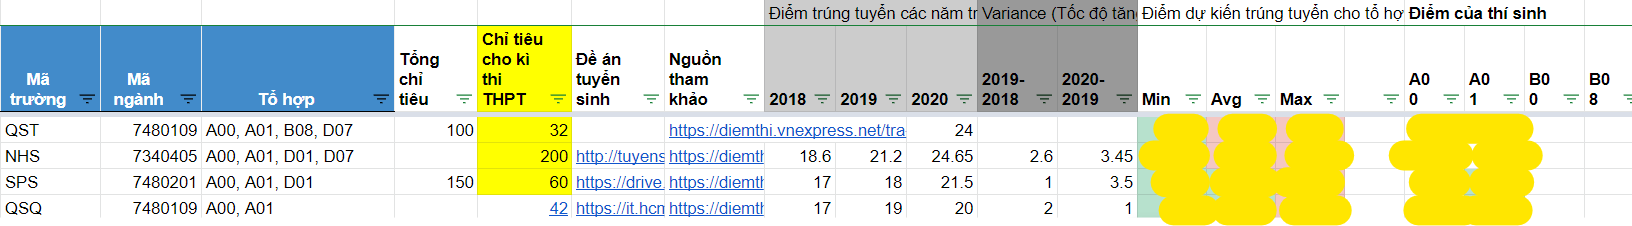
Cái file spreadsheet của mình bầy hầy lắm nên không dám share, cap màn hình cho mọi người coi chơi thôi:
Bảng điểm theo tổ hợp
Tốc độ tăng giảm điểm chuẩn của ngành
Phân tích nguyện vọng
Bước 7: Đối chiếu thực tế, xem xét mức độ chính xác của mô hình
Cập nhật 10h sáng ngày 16/9: Em gái mình đã trúng tuyển vào khoa CNTT, trường Đại học Sư phạm TPHCM (nguyện vọng 3). Đây là một lựa chọn mà mình đã cân nhắc rất kĩ để xếp ngay dưới 2 nguyện vọng rất cao (Tự nhiên & Ngân hàng). Em cũng đủ điểm với ngành Khoa học dữ liệu, Đại học Quốc tế, tuy nhiên do vấn đề học phí, tụi mình đã xếp nó xuống thứ tư.
Như vậy, với sự cân nhắc kĩ lưỡng, em mình đã chọn được một ngôi trường vừa sức, với ngành học mà em yêu thích. Giờ tụi mình sẽ tiếp tục lên kế hoạch học tập và phát triển các kĩ năng cần thiết để có thể gia nhập thị trường lao động trong 4 năm tới.
Có người hỏi tại sao mình lại phải phức tạp như vậy, thì sau đây là một số ưu điểm của việc phân tích kĩ:
Giúp hiểu rõ cái mình muốn gồm những gì (ngành học, danh tiếng của trường, học phí, thầy cô…), và cái nào là quan trọng, để mở rộng danh sách lựa chọn,
Nhận diện ra “vũ khí bí mật”. Ví dụ, em gái mình dự định xét tuyển khối A1, nhưng sau khi tính điểm của tất cả các tổ hợp thì điểm D7 của ẻm là cao nhất => dùng tổ hợp này xét tuyển sẽ có lợi hơn
Cảm ơn mọi người đã đọc tới đây. Chúc các bạn tân sinh viên sẽ có một quãng thời gian thật đẹp <3
To complete any project of any lasting importance in people analytics, you have to master concepts and activities that live in many different domains. This cheat sheet provides some information about these domains, concepts, and activities.
The Four S People Analytics Framework
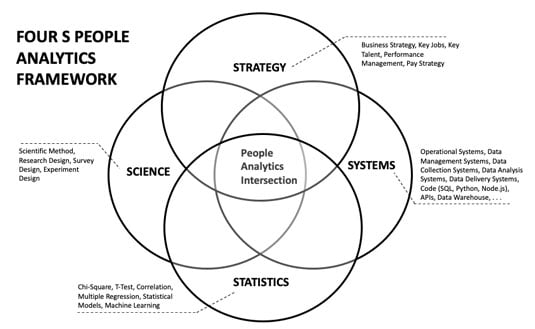
One way of defining people analytics is to say that people analytics is what lives at the intersection of people strategy, science, statistics. and systems — what I like to call the Four S’s. (See the following figure.) If you take any of the S’s away, you might get something like people analytics, maybe even a precursor of people analytics, but it is not people analytics proper.
The Four S People Analytics Framework (The People Analytics Intersection).
Following are some ingredients to each of the Four S components that represent an important concept or activity to learn if you hope to be successful at people analytics:
Strategy
Strategy encompasses the plans and policies intended to help a company gain a sustainable edge over its competitors as efficiently as possible. It represents the art and science of developing and using the object and actions within control of an organization in a deliberate manner in order to increase the probabilities of victory and to lessen the chances of defeat.
Concept
Description
Business Model
Business models are frameworks that describe how a business creates value. The areas of focus of a business model include: problem focus, target customer focus (market), unique value proposition, channels, methods of generating revenue, total addressable market (projected target customer market estimates), projected costs, projected revenues, and any believed or real defendable product differentiation advantages. The work we do in people analytics is intended to support the organization in creating, adapting, or defending a specific business model.
Segments, Target Segments
Segments are groups of people who exhibit similar attributes or characteristics. Segments must be distinct from other groups. Segments need not be demographic in nature — segments may consist of individuals who share a similar response to survey questions or display common behavioral patterns in reaction to some stimulus. The concept of target segments is of central importance to marketing; in people analytics, we look to apply this same concept to human resources. In people analytics you also look to make Human Resources serve the interests of what the organization is trying to represent to its target market segments.
Differentiation
Product differentiation (or simply differentiation) is the process of distinguishing a product or service from others in order to make it more attractive to a particular target market segment. In people analytics, we are interested in those key jobs, competencies, attitudes, and behaviors that must be created to help the company create and sustain its product leadership in the marketplace in some category of product differentiation.
Job Families and Job Levels
A job family is defined as a set of jobs (with or without related titles) that share a series of related knowledge, skills, abilities, and other characteristics (competencies). Job families can be further classified by level, defining a progressive expression of the job family’s contributions to a business.
Key Jobs and Key Talent
Key jobs or key talent are those jobs or people that are critically important for a particular business model. They demonstrate the differentiating competencies (knowledge, skills, abilities, and others defined characteristics) that are pivotal to affect the success of a particular business model and product differentiation strategy.
Performance Management
Performance management is a human resource management strategy and operational process that aims to align employee expectations and actions with the expectations of managers and company leadership with the objective of improving individual and collective performance. Performance management is a process for evaluating employee performance in reference to the competencies, attitudes, and behaviors previously demonstrated as critical for successful job, team, or company performance. Group facilitated exercises such as the Critical Incident Technique may be combined with other forms of data to derive a valid and reliable measurement system that can be applied to employee selection and ongoing feedback in support of the broader context of performance management and business strategy.
Compensation Philosophy and Compensation Strategy
Compensation philosophy or strategy represents the standards, goals, and plans by which those responsible for employee compensation will help the company prioritize available budgets to achieve the goals of the company through better control over employee attraction, motivation, and retention. Some of the various concepts that can be applied and measured include internal equity and fairness (similarity in pay among similar jobs), market differentiation (comparison to pay at other companies), and how the company chooses to compensate differently for different experience, competency, tenure, performance and job importance.
Science
Science involves the systematic study of the structure and behavior of the physical world through the organization of facts and theories and continual refinement of those facts and theories through observation and experiment.
Concept
Description
Scientific Method
The scientific method is a body of techniques for investigating the world, acquiring new knowledge, or correcting previous knowledge consisting in systematic observation, measurement, and experiment, and the formulation, testing, and modification of hypotheses.The scientific method is an iterative process involving the following steps:1. Make observations2. Identify questions3. Formulate hypotheses. Develop testable predictions4. Conduct an experiment. Gather data to test predictions5. Analyze data6. Refine, alter, expand or reject hypothesis (either go on to 7 or go back to 3)7. Develop or alter general theories.
Inductive Analysis
Inductive reasoning begins with detailed observations of the world and from these moves towards generalizations and theories of what they mean. When following an inductive approach, beginning with a given set of data, a researcher identifies relationships, developing theories as she proceeds. No hypotheses can be found at the initial stages of the research and the researcher is not sure about the type, nature or application of the research findings until the study is completed.
Deductive Analysis
Deductive reasoning starts with a general theory, statement, or hypothesis and then works its way down to a conclusion based on evidence. The main difference between inductive and deductive approaches to research is that whilst a deductive approach is aimed and testing theory, an inductive approach is concerned with the generation of new theory emerging from the data.
Research Design
A research design is the set of methods and procedures used in collecting and analyzing measures of the variables specified in a problem theory. The research design defines the study type (e.g. review, descriptive, correlational, experimental or meta-analytic) and sub-type (e.g. longitudinal, cross-section, cohort, . . .), research problem, hypotheses, independent and dependent variables, experimental design, and, if applicable, data collection methods (survey, systems, ….) and a statistical analysis plan. A research design is a framework that has been created to find answers to research questions.
Survey Design
Survey design is a sub field of applied behavioral science using questionnaires. Important elements of survey design include decisions about the technique of survey data collection, the technique to select a sample from a population, and the mathematical techniques for accurately interpreting what is found.
Experiment Design
Experimental research is any research conducted with a scientific approach, where a set of variables are kept constant while the other set of variables are being measured as the subject of experiment change. Experimental research is the gold standard for investigating causal (cause/effect) relationships empirically. You can use experimental research to compare one group to itself over time or two groups two each other. In all designs, independent variables (X) are manipulated to see if it the change or difference between the samples (or groups) has an effect on the dependent variable (Y), generally using t-tests (see statistics). In contrast, an observational study does not involve experimental manipulation.Experimental research is used to test hypotheses. A hypothesis is a testable statement that is formulated by the researcher to confirm a theory or address a specific question. The researcher’s job is to design an experiment that will support or disprove the hypothesis.
Statistics
Statistics is the branch of mathematics that deals with the collection, organization, analysis, and interpretation of numerical data.
Concept
Description
Chi-Square
A statistical significance test used for variables that have been organized into categories and presented in a crosstab or contingency table. A cross-tab displays the frequency distribution of the two or more variables crossed against each other. When you summarize two categorical variables in a cross-tab, your implicit interest is “Are the two variables related or independent?” Chi-Square is a statistical technique that can be applied to assess this very question.
T-Test
A statistical method of assessing the significance of differences between two mean values for the same variable. The t-test is a statistical method often used in experimental design when comparing groups or samples for purposes of determining the impact of some change.
Correlation
Correlation is a statistical technique for determining the statistical relationship between two variables. In other words, if we are measuring two variables and one variable increases, does the other consistently increase at some related amount?
Multiple Regression
Multiple regression is employed to understand how multiple independent variables (x) are statistically related to the dependent variable (y) and to what degree. It helps mathematically describe the form of the relationships between multiple variables (x1, x2, x3) and (y), it helps to mathematically determine how good the overall model (inclusion of all variables) is at describing or predicting the behavior of (y), and it helps to mathematically isolate the independent contribution of each (x) variable to the total variance in (y).
Factor Analysis
Factor Analysis is a statistical technique that is useful for organizing and understanding datasets where there are high numbers of observed variables that are believed to reflect a smaller number of underlying variables. The research questions factor analysis can help you answer include:How can we better understand and classify the variables in a dataset based on the observed interdependencies?Based on the observed interdependencies, what variables in this data can be combined into a single factor? For example, can performance at running, ball throwing, batting, jumping, and weight lifting be combined into a single factor such as general athletic ability?Based on the observed interdependencies, what are the most important variables in this dataset?Based on the observed interdependencies, do survey items (or other measurement instruments) measure what they purport to measure?
Machine Learning
Machine learning is the application of computer algorithms to build a mathematical model of sample data (known as training data) in order to make predictions or decisions without being explicitly programmed to perform the task.
Systems
A system is computer software designed to perform a group of coordinated functions, tasks, or activities for the benefit of the user. A system is made up of components that work together. A system takes an input, changes it according to the system’s use, and then produces an outcome. Inputs and outputs are strung together between systems to accomplish broader objectives.
Concept
Description
Operational Systems
The systems that facilitate the processing of transactions necessary for the day-to-day administration of the company.
Data Collection Systems
Systems that facilitate the process of structured data collection for purposes of analysis.
Data Management Systems
Systems that facilitate the process of moving, changing, and storing data.
Data Analysis Systems
Systems that facilitate the process of discovering insight and validating or invalidating hypotheses using statistics.
Data Delivery Systems
Systems that facilitate the process of absorption and use of data by placing it in a visual context in reach of users.
Data Warehouse
A data warehouse is a central repository of integrated data from one or more disparate sources. A data warehouse is a data management sub-system and is considered to be a core component of business reporting and analysis.
Operational Data Stores and Analytical Data Stores
Operational data stores consist of a method of storing transactional data that is built for the integrity and efficiency of the operational application where the data stemmed from — normalized tables, for example. In contrast to operational data stores, analytical data stores use methods of storing data that are built for the integrity and efficiency of reporting and analysis — through de-normalized columnar design, for example. In the case of statistical analysis, the data must be put in a specific columnar format dictated by the statistical procedure. In other cases, the design of the dataset is for faster query performance.
Data Visualization
Data visualization is the process of putting numerical data in a pictorial or graphic format. Data visualization helps users comprehend information quickly and spot patterns, trends, and correlations in the data without abstract ideas or mathematics. Data can be visualized in a wide range of applications, but some applications are designed to allow the user to change the design of graphs, filter graphs, or drill down into graphs so that through exploration they can obtain the answers to their own questions.
Data Dashboard
Generally, a data dashboard is understood to be the output of a data delivery system that displays together two or more metrics visually so that the user can monitor some measurable features of a business, department, or process. A popular data visualization expert, Stephen Few, defines a dashboard more specifically as “a visual display of the most important information needed to achieve one or more objectives; consolidated and arranged on a single screen so the information can be monitored at a glance.”
API
API stands for Application Programming Interface. An API is an interface designed into an application that allows other applications to communicate with it. In other words, an API is the messenger that can deliver a request to a system and then deliver the response back. The ability to communicate with application APIs in order to get data and move it to where it is needed is of growing importance to analytics.
Code (SQL, Python, Node.js)
Structured Query Language (SQL) is a standard computer language for relational databases and for performing various data operations. The software is coded to query, join, merge, update, and modify data. As a relational data system, it is comprised of a set of tables with columns and rows that contain data. As the original code for databases, SQL excels at accessing and organizing data, is relatively easy to learn, and is thus almost common knowledge among coders.Python is a general purpose, high-level coding language that has long been used to develop software on the web and in apps; in recent years, however, it has found increasing popularity among professionals who work with data. Python was designed to empower its users, emphasizes code readability, and leverages syntax that allows programmers to accomplish tasks in fewer lines of code than prior languages. Python users tout its use due to its easiness to learn, the accessibility of the language, its expansive library of open source data tools and testing instruments.Node.js is an open-source, cross-platform JavaScript run-time environment that executes JavaScript code outside of a browser. Node.js supports web applications with real-time, two-way connections, where both the client and server can initiate communication, allowing them to exchange data freely. Consequently, Node.js unifies web application development around a single programming language (JavaScript) rather than different languages for server side and client-side scripts. Node.js shines in real-time web applications employing push technology rather than WebSocket’s. Node.js is useful for developing data applications designed to run on the web and for extracting and moving data between web applications.
The Triple A Measurement Framework
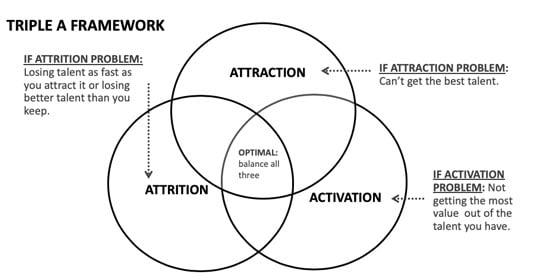
The Triple A Measurement Framework (see the following figure) provides the fundamental measurements and analysis for the three big people-related problems each company needs to solve if they hope to grow as a business: attracting talent, activating talent, and controlling the rate of talent exit (attrition).
The Triple A Measurement Framework
Attraction
Attraction represents a set of metrics and analyses intended to measure the attractive force of the company to acquire the quality of talent it wants. In other words, it poses the question “How are you doing on getting talent into the company?”
Concept
Description
Headcount-SOP
The number of people in a segment at the start of the selected time period.Calculation: [Period].[Segment].(count of active employees on the first day of the period)
Headcount-EOP
The number of people in a segment at the end of the selected time period.Calculation: [Period].[Segment].(count of active employees on the last day of the period)
Average Headcount Simple
The average number of people in a segment during the selected time period, calculated with a count at the beginning and end divided by two.Calculation: Period].[Segment].Headcount-SOP + [Period].[Segment].Headcount-EOP ÷ 2
Hires
A hire is someone who was not an employee that became an employee. As a metric, hires is a count of the number of hires in a particular segment in a particular time period.Calculation: [Period].[Segment].(count number of hires)
Hire Rate
The number of hires in a segment during the reporting period expressed as a percentage of that segment’s average headcount in that reporting period.Calculation: [Period].[Segment].Hires ÷ [Period].[Segment].Average-Headcount-Simple × 100
Headcount Growth
The increase in the number of employees in a segment from the start of the period to the end of the period. Calculation: [Period].[Segment].Headcount-EOP – [Period].[Segment].Headcount-SOP
Headcount Growth Rate
The growth in the number of people in a segment during the selected time period expressed as a percentage of headcount at start of period.Calculation: [Period].[Segment].Headcount-Growth / [Period].[Segment].Headcount-SOP ×100
Headcount Plan
A particular segment’s headcount plan on a particular date.Calculation: [Period].[Segment].(sum of headcount plan)
Headcount Plan Achievement Percent
A particular segment’s headcount as a percentage of that segment’s headcount plan on a particular date, expressed as a percentage.Calculation: [Period].[Segment].Headcount-EOP / [Period].[Segment].Headcount-Plan ×100
Candidates
Candidates are people who are considered for open jobs. A candidate may apply for multiple jobs and therefore may have multiple applications. As a result, there are typically more applications than there are candidates. As a metric, candidates is a count of the number of candidates in a particular segment in a particular time period.Calculation: [Period].[Segment].(count the number of candidates)
Applications
Applications are formal requests to be considered for an open job. As a metric, applications is a count of the number of applicants in a particular segment in a particular time period.Calculation: [Period].[Segment].(count the number of applications)
Interviews
Interviews are when the people who will participate in the hiring decision formally assess a candidate for decision. As a metric, interviews is a count of the number of interviews in a particular segment in a particular time period.Calculation: [Period].[Segment].(count the number of interviews)
Offers
The number of job offers in a selected period. Offers are when a candidate has been selected and a formal invitation has been given to the candidate to join the company.Calculation: [Period].[Segment].(count the number of offers)
Offer Accepts
The number of candidates with offers who have accepted those offers.Calculation: [Period].[Segment].(count the number of offers accepted)
Recruiting Stage Pass Percent
The percentage of applicants that pass from a defined recruiting stage to the next recruiting stage, by segment, by period. In this example, Stage1 = phone screen. Stage2 = onsite interview.Calculation: [Period].[Segment].Stage2.Applicants ÷ [Period].[Segment].Stage1.Applicants × 100
Segment Yield-Percent
The percentage of applicants that make it through all recruiting stages and then accept an offer, by segment, by period.Calculation: [Period].[Segment].Offer-Accepts / [Period].[Segment].Applicants × 100
Average Hires per Recruiter
The average number of hires made per recruiter in a given period.Calculation: [Period].[Segment].Hires [Period].[Segment].Recruiter.Average-Headcount-Simple
Average Phone Screens Per Hire
The average number of phone screens it took to make a hire in a given period.Calculation: [Period].[Segment].Phone-Screens [Period].[Segment].Hires
Average Interviews Per Hire
The average number of interviews it took to make a hire in a given period.Calculation: [Period].[Segment].Interviews [Period].[Segment].Hires
Average Time to Fill
The average number of days elapsed between the date a job requisition is approved and the applicant offer accept date.Calculation: [Period].[Segment].(sum of days between job requisition date and offer accept) [Period].[Segment].Offer-Accepts
Average Time to Start
The average number of days elapsed from the date a job requisition is approved to the date a new hire begins work.Calculation: [Period].[Segment].(sum of days between job requisition date and employee start date) ÷ [Period].[Segment].Hires
Average Time to Start Candidate View
The average number of days elapsed between an application start date and the date a new hire begins work.Calculation: [Period].[Segment].(sum of days between application start date and employee start date) ÷ [Period].[Segment].Hires
Brand Index
A survey key performance indicator (KPI) calculated from survey items designed to measure company brand recognition among a target candidate segment in a given period.
Activation
Activation represents a set of metrics and analyses intended to measure the proportion of people and teams who have all the basic requirements to produce at a high-performance level. In other words, it poses the question “How are we doing at creating the conditions that make for productive employees?”
Concept
Description
Human Capital ROI (HCROI)
Pretax profit for each dollar invested in employee pay, including cash compensation, benefits, and equity compensation.Calculation: (Revenue – (Total Cost – (Regular Compensation Cost + Total Benefit Costs))) / (Regular Compensation Cost + Total Benefit Costs).Alternate Calculation: (Profit ÷ average number of employees) ÷ (Employee Cost ÷ average number of employee)
Expected Employee Lifetime Value (ELV)
Expected employee lifetime value (ELV) is a measurement of the estimated financial value (profit) that an employee brings to an organization over their entire lifetime of working for the company. In this calculation, the employee lifetime is the period that starts when an employee first joins your business and ends on that person’s last day. You can calculate ELV by individual, by segment, or by average.Calculation: 1) Calculate (HCROI), 2) Calculate average annual compensation, 3) Calculate (or estimated) average tenure, 4) multiply it out: (HCROI) × (Annual Compensation) × (Lifetime Tenure). You will get a large dollar value.
CAMS Index
A survey key performance indicator (KPI) calculated from survey items designed to infer the presence of four conditions: capability, goal alignment, motivation, and support (CAMS). There are 8 items and each item has a possible score of 0 to 10, resulting in an index that ranges 0–80.
Activated Percent
Estimated percentage of a segment that is activated in a given time period. Count the number of people who have responded positively enough to the eight CAMS items to be considered “activated” (CAMS index equal to or greater than 70) then divide by the number of survey responses in the segment and multiple by 100. Calculation: (# activated in segment) ÷ (total survey responses in the segment) × 100
Net Activated Value (NAV)
Net Activated Value combines ELV and Activated Percent into a single metric. NAV discounts the expected value of a segment, taking into consideration that because not all employees are activated, the segment can’t possibly deliver full value. Segment NAV = (Segment Activated Percent) × (Segment ELV).
Culture
Organization culture may be thought of simply as a “corporate personality.” Culture is the shared values, beliefs, and unstated rules that influence the behavior of people as members of an organization. Culture and cultural congruence can be measured through survey items. An example provided in People Analytics For Dummies is the OCAI.
Climate
Organizational climate is a measurement of the patterns of opinion, attitudes, and feelings that characterize people’s perception of life in the organization at a particular time and context. You quantify organizational climate using surveys, usually by first listing a variety of experiences or ideas as a series of statements and then measuring agreement or disagreement with these statements.
Attrition
Attrition represents a set of metrics and analyses intended to measure the degree of control the company has over the quality of the talent it’s able to retain versus the quality of talent it allows or encourages to exit. In other words, it poses the question “How are you doing keeping your highest performers, while letting others go on to the next stop in their career?”
Concept
Description
Exits
An exit is someone who was an employee that leaves the company and is no longer an employee. As a metric, exits is a count of the number of exits in a particular segment in a particular time period.Calculation: [Period].[Segment].(count number of company exits)
Exit Rate
The number of employee exits from a segment during the reporting period as a percentage of segment average headcount.Calculation: [Period].[Segment].Exits ÷ [Period].[Segment].Average-Headcount-Sample × 100
Voluntary Exit Rate
The number of employees who exited during a timeframe, with a specific exit classification type = voluntary.Calculation: [Period].[Segment].[Voluntary].Exits ÷ [Period].[Segment].Average-Headcount-Sample × 100
Involuntary Exit Rate
The number of employees who exited during a timeframe, with a specific exit classification type = Involuntary.Calculation: [Period].[Segment].[Voluntary].Exits ÷ [Period].[Segment].Average-Headcount-Sample × 100
Regretted Exit Rate
The number of employees who exited during a timeframe, with a specific exit classification type = Voluntary & Regretted (Voluntary-Regretted). Regretted may be defined as anyone with a performance rating greater than average.Calculation: [Period].[Segment].[Voluntary-Regretted].Exits ÷ [Period].[Segment].Average-Headcount-Sample × 100
Retention Rate
The percentage of all employees that started the time period that did not exit the company in the time period.Calculation: [Period].[Segment].(count of people who start period who are still active employees at end of period) ÷ [Period].[Segment].Headcount-SOP × 100
Commitment Index
A survey key performance indicator (KPI) calculated from survey items designed to measure organizational commitment among a segment in a given period.
CAMS Activation Index Framework
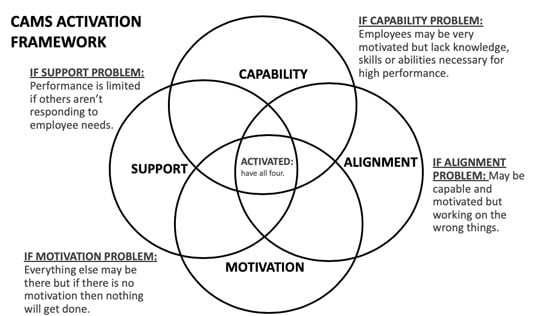
The theory of activation proposes that, taken down to its essence, four conditions must exist for an employee or a team to consistently produce at or above performance expectations. The employee or team must: a) be capable of performing the actions required (Capability), b) be aligned on what a good result looks like (Alignment), c) be motivated to perform the actions (Motivation), and d) have all the tools and support that are required for successful performance of those actions (Support). (See the following figure.)
The CAMS Activation Index Framework
If any of the four essential conditions (Capability, Alignment, Motivation or Support) is missing, it’s difficult, if not impossible, for the employee or team to perform reliably. For more details on what each condition is and how it is measured, see below.
Capability
In its most basic sense, an individual who is capable has the knowledge, skills, ability, and other characteristics necessary to perform the job. Capabilities are what people bring to the company — personal qualities such as technical knowledge, learning agility, social skills / emotional quotient (EQ), and grit, for example.
Scale: Measured by agreement using a scale of 0 (Strongly Disagree) to 10 (Strongly Agree):
Concept
Description
Team Capability
My primary work group has all the capabilities it needs right now to achieve top performance as a team.
Individual Capability
I have the capabilities I need right now to achieve top performance in my current role right now.
Alignment
Employees who are aligned know what they’re expected to accomplish, under what conditions, and how they’re performing in relation to those expectations. The company can increase alignment by way of goal setting, performance appraisal, and regular executive, manager, and employee communication.
Scale: Measured by agreement using a scale of 0 (Strongly Disagree) to 10 (Strongly Agree):
Concept
Description
Team Alignment
There is a clear objective around which myself and the people I work with rally.
Individual Alignment
I have a clear understanding of the difference between an average contribution and a great contribution for my role.
Motivation
Motivation is the general desire or willingness of someone to do something. Motivation reflects the interaction of personal preferences with the job, working environment, company culture, leadership, managers, peers, rewards, and incentives, which result in motivation or demotivation to perform the tasks at hand.
Scale: Measured by agreement using a scale of 0 (Strongly Disagree) to 10 (Strongly Agree):
Concept
Description
Team Motivation
The people I work with are willing to help even if it means doing something outside of their usual activities.
Individual Motivation
I am motivated to do more than the minimum expectations.
Support
This category covers not only the particular technical tools used to perform work but also any other support that’s necessary, such as access to documentation, access to manager and teammates to help solve problems, resources designed to produce skills and knowledge in the individual, technical support, and camaraderie. (For , use the name of your own organization.)
Scale: Measured by agreement using a scale of 0 (Strongly Disagree) to 10 (Strongly Agree):
Concept
Description
Team Support
I have the cooperation and support from others at I need to be successful.
Individual Support
I have the resources and tools I need to be successful.
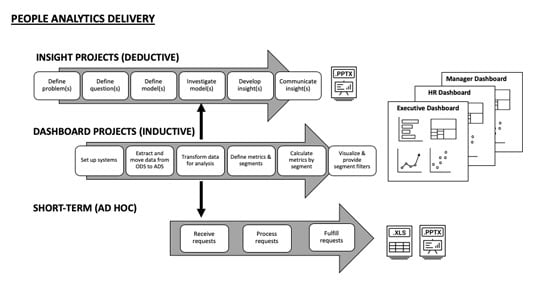
People Analytics Delivery
The following figure illustrates how both deductive and inductive analysis approaches can be incorporated in a people analytics delivery model.
Your People Analytics Delivery Model may include both deductive and inductive approaches.
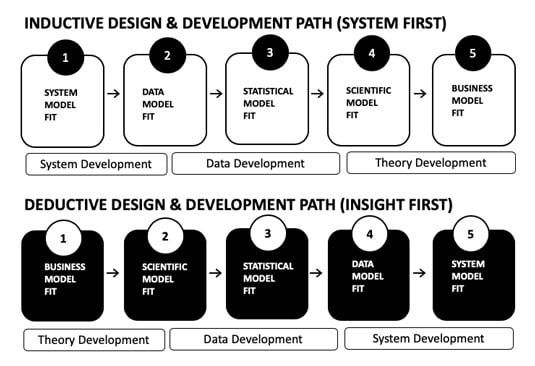
People Analytics Design & Development
The following figure illustrates how deductive and inductive people analytics design & development workflows contrast.
The Five Models of People Analytics may be organized for both inductive and deductive approaches.
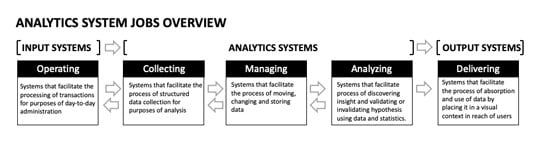
People Analytics System Jobs Overview
The following figure provides a high-level overview of the five essential jobs of technology systems in analytics.
Analytics Systems Jobs Overview
About the Book Author
Mike West was a founding member of the first people analytics teams at Merck, PetSmart, Google, and Children’s Health Dallas before starting his own firm, PeopleAnalyst, LLC. He has helped companies large and small design people analytics applications and start their own people analytics teams. Mike brings a unique perspective about how to use data to create winning companies and great places to work.